個人ブログはどこまで自動化できる?自動化しやすい作業と人が判断すべき作業
ゆまラボで実際に進めたGA4、X投稿、GA4 Data API、Cloudflareビルド、人気記事の自動表示を基に、個人ブログで自動化しやすい工程と、人間の判断を残したい工程、自動化を広げるデメリットを分けて考える。
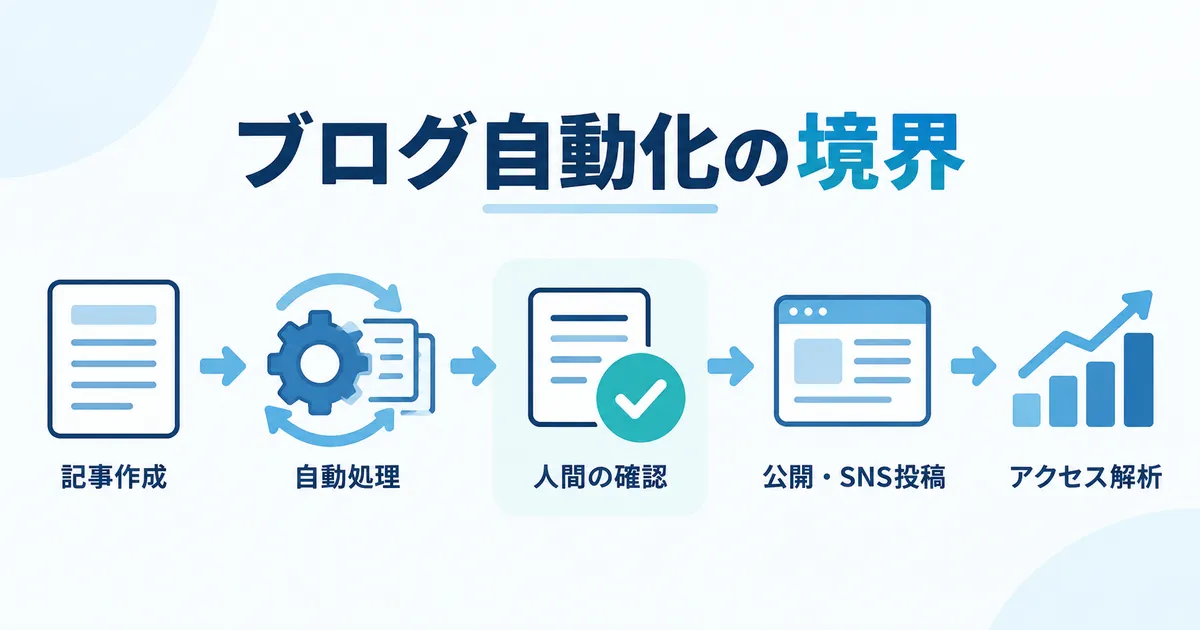
ブログ運営で同じ作業を繰り返していて、 「もっとAIやスクリプトに任せたい」 「でも全部自動にすると誤公開が怖い」 「どこまで自動化すれば本当に楽になるのか分からない」 と感じていないでしょうか。自動化できる作業と、自動化した方がいい作業は同じではありません。
ゆまラボでは、GA4の導入、記事別PV取得、CloudflareビルドからのGA4認証、PV上位記事のTOP自動表示、X投稿の補助などを実際に進めてきました。ルールが決まった集計や公開処理は機械へ渡しやすい一方、記事内容や公開判断まで自動化すると、別の確認作業も増えます。
この記事では、実際に自動化した工程を材料に、自動化しやすい作業・人の判断を残したい作業・自動化したことで新しく増える保守を分けて考えます。「どこまで自動化すると運用が楽になるか」を決めたい方に向けた記事です。
- 人気記事を自動表示するならGA4とCloudflare Analyticsどちらを使う?取得方法を比較
- AstroにGA4を導入する方法|Google Analytics設定からリアルタイム計測まで
- Bing Webmaster Toolsにサイトを登録する方法|Search Console連携とX流入も確認
- GA4 Data APIで記事別PVを取得する方法|Node.jsで実データを取得
- GA4 Data APIをCloudflareビルドで使う方法|OAuth認証へ切り替えた手順
- GA4のPV上位記事をトップページへ自動表示する方法
ルールが決まった処理は機械へ渡しやすい#
ゆまラボで分かりやすいのは、公開や集計のように処理手順を固定できる部分になる。
Astroの記事はGitHubへpushするとCloudflare側でビルドされる。毎回Cloudflareの管理画面から手動デプロイする形にはしていない。
Xへの投稿でも、投稿用URLには同じUTMを使っている。
utm_source=x
utm_medium=social
utm_campaign=article_publishX投稿の運用では、実際にXへ投稿している状態と、GA4のトラフィック獲得でx / socialが記録されていることまで確認した。
アクセス解析も同じ方向へ進んだ。
scripts/ga-pageviews.mjsからGA4 Data APIを呼び出し、pagePathとscreenPageViewsを取得する処理を作った。期間は30daysAgoからyesterdayまでとし、/blog/配下を対象にPV順で扱う。
この時点では、ローカルから取得するところまで。
その処理をCloudflareのビルドでも使うため、認証方法も変更した。サービスアカウントのJSONキーを作ろうとしたが、親側から適用されていたiam.disableServiceAccountKeyCreationで作成できず、ポリシーを変更する権限もなかった。
そこでサービスアカウント方式を続けず、OAuthとCloudflare Secretを使う構成へ切り替えた。
取得したGA4データはTOPページまでつないだ。直近30日のPVから上位3記事を選び、「注目コンテンツ」へ自動表示する。TOPにはPV数や順位そのものは出さず、既存の記事カードを使う形にしている。Cloudflareビルドが成功し、3件が生成されるところまで確認している。
GA4
↓
Data API
↓
Cloudflare build
↓
上位3記事を選択
↓
TOP「注目コンテンツ」
「人気記事を自動表示したい」と考えた構想が、実際の表示処理までつながった。
ここは自動化と相性がよい。
「直近30日」「記事ページだけ」「PV順」「上位3件」という条件を決めた後は、記事を公開するたびに人がGA4を開いてランキングを作り直す必要がない。
自動化するほど、入力データの扱いが重要になる#
人気記事を自動表示できるようになると、別の問題も出る。
自動化した処理は、入力されたデータをそのまま使う。
GA4の数字に自分の確認アクセスが含まれていれば、その数字もPVとして扱われる。ゆまラボではGA4導入時、自分でサイトを開いた直後にリアルタイム計測へアクセスが入ることを確認している。
そのため、Data APIから値を取れることと、その値をそのままサイト上の判断へ使ってよいことは同じではない。
GA4へデータが入る
↓
Data APIで取得できる
↓
ランキングを計算できる
↓
TOPへ自動表示できる
この流れの途中に人の操作がなくても、最初のデータが適切とは限らない。
手作業なら、数字を見た時点で違和感に気付く場合がある。自動処理では、条件に合っていればそのまま次へ進む。
自動化を増やすほど、「処理が動いたか」に加えて「何を入力として使っているか」も確認する必要が出てくる。
外部サービスをつなぐと認証も保守対象になる#
第9回で詰まったのはGA4の集計ロジックより、CloudflareからGoogle Analyticsへアクセスするための認証。
ローカルでData APIを実行できても、その認証状態をCloudflareのビルド環境へそのまま持っていくことはできない。
サービスアカウントのキーを作る案は組織ポリシーで止まった。そこでOAuthへ変更し、同意画面、スコープ、公開状態、Cloudflare側で使うSecretまで確認することになった。
自動化前は存在しなかった作業になる。
ローカルでAPI取得
↓
本番ビルドでも取得したい
↓
認証方法を決める
↓
Secretを管理する
↓
期限・権限・設定変更も確認する
外部サービスを1つ追加すると、APIだけでなく認証方式も仕組みの一部になる。
これは自動化の大きなデメリットになる。
クリック作業は減るが、止まったときに見る場所は増える。
Astroのコードだけを見ればよいわけではなく、GA4、Google Cloud、OAuth、Cloudflareのどこで止まっているかを切り分ける必要がある。
「処理成功」と「内容が正しい」は別に残る#
記事生成も同じになる。
AIへ下書きを作らせること自体は難しくない。画像も生成できる。Markdownも作れる。ビルドも自動で確認できる。
ただし、ビルドが通ったことは本文が正しいことを意味しない。
ゆまラボでは、ChatGPTとGeminiへ同じ質問を送り、Web検索の有無で回答を比較した。バージョン番号、上限値、API名、設定パスなどは、文章として自然でも現在の仕様とずれることがあった。
AI生成記事をファクトチェックする方法|公開前に確認する項目と編集手順
画像でも、依頼していない企業ロゴが生成画像へ入ったことがある。その画像は公開せず、企業ロゴや公式UIを生成画像へ入れないルールを追加した。
AIに記事の画像を作ってもらったら、頼んでいない企業ロゴまで出てきた
ここは機械的な成功判定だけでは完了できない。
Markdownが生成できた
ビルドが通った
画像ファイルが存在する
リンクが404ではない
という確認と、
本文の断定に根拠があるか
現在の仕様か
実体験として書いてよいか
画像を公開して問題ないか
という確認は別になる。
自動化すると前者はかなり減らせる。後者まで同じように扱うと、確認していない内容をそのまま公開しやすくなる。
数字から次の記事まで自動で決めるか#
現時点では、アクセスデータをサイト表示へ戻すところまで実装している。
ここからさらに進めるなら、人気記事の数字を次の記事候補へ使うこともできる。
よく読まれている記事
↓
関連テーマを抽出
↓
次の記事候補を作る
↓
記事を生成
↓
公開後のPVを再取得
ただし、これは現在のゆまラボで実装済みの処理ではない。
ここまで自動にすると、数字が出ているテーマを繰り返し選びやすくなる。
ゆまラボには、GA4導入、Cloudflareの設定、画像生成の失敗など、アクセス数とは関係なく実際の作業から生まれた記事も多い。
アクセスデータは候補を出す材料には使える。ただ、何をサイトに残すかまでPV順だけで決めると、実験記録としての方向は変わってくる。
この判断は人間側に残したい。
自動化すると見えなくなる作業もある#
自動化は手順を減らすが、同時に途中経過を見る機会も減らす。
現在の人気記事表示では、ビルド時にData APIから数字を取得して上位3件が決まる。運用上は便利だが、毎回GA4の画面を見なくてもTOPが更新される。
これは目的どおりの動きになる。
一方で、ランキングの変化を人が見る機会も減る。
例えば、急に特定の記事だけPVが増えた、意図しないURLが集計対象に入った、アクセス元が偏った、といった変化は、自動表示だけを見ていると理由までは分からない。
自動化したあとも、必要なときに元データへ戻れる状態は残した方がよい。
「画面を毎日開く必要をなくす」と「元データを見なくてよい」は別になる。
ゆまラボで人間側に残したい部分#
ここまで進めた状態で見ると、機械へ渡しやすい範囲はかなり広い。
| 扱い | ゆまラボでの例 |
|---|---|
| 自動化しやすい | GitHubからCloudflareへのビルド・公開、UTM URL生成、GA4 Data API取得、PV順の集計、TOPの人気記事表示 |
| AIへ任せて確認する | 記事下書き、画像生成、要約、投稿文の作成、内部リンク候補 |
| 人が判断を残す | 記事化するテーマ、事実確認、実体験として書ける範囲、公開可否、認証方式の変更、例外時の対応 |
ここでは、自動化率より運用全体の負担を見て判断する。
GA4 Data APIをサイト表示へつなぐ一連の作業でも、コードを書けば終わりではなかった。
ローカルで取得する。
Cloudflareで使うための認証を決める。
組織ポリシーでサービスアカウントキーを作れないことを確認する。
OAuthへ変更する。
ビルドへ接続する。
取得したデータをTOP表示へ使う。
この途中には、機械処理と人の判断が何度も混ざっている。
個人ブログの自動化では、この境界を消すより、どこから先が自動で、どこで人が判断するのかを明示した方が運用しやすい。
自動化を追加するときは、少なくとも次を確認したい。
- 入力データが誤っていた場合、どこまで自動で反映されるか
- 認証や外部APIが止まった場合、どこで検知できるか
- 処理成功と内容確認を分けられているか
- 自動処理の結果から元データへ戻れるか
- サイトの方向を決める判断まで数字やAIへ渡していないか
現在は、「自動化できるところを探す」段階から、「自動化した仕組みをどこまで信用して先へ進ませるか」を考える段階へ移っている。
関連記事
Codexの利用枠を短時間で20ポイント消費したら止める―AGENTS.mdとApp Serverを実際に試す
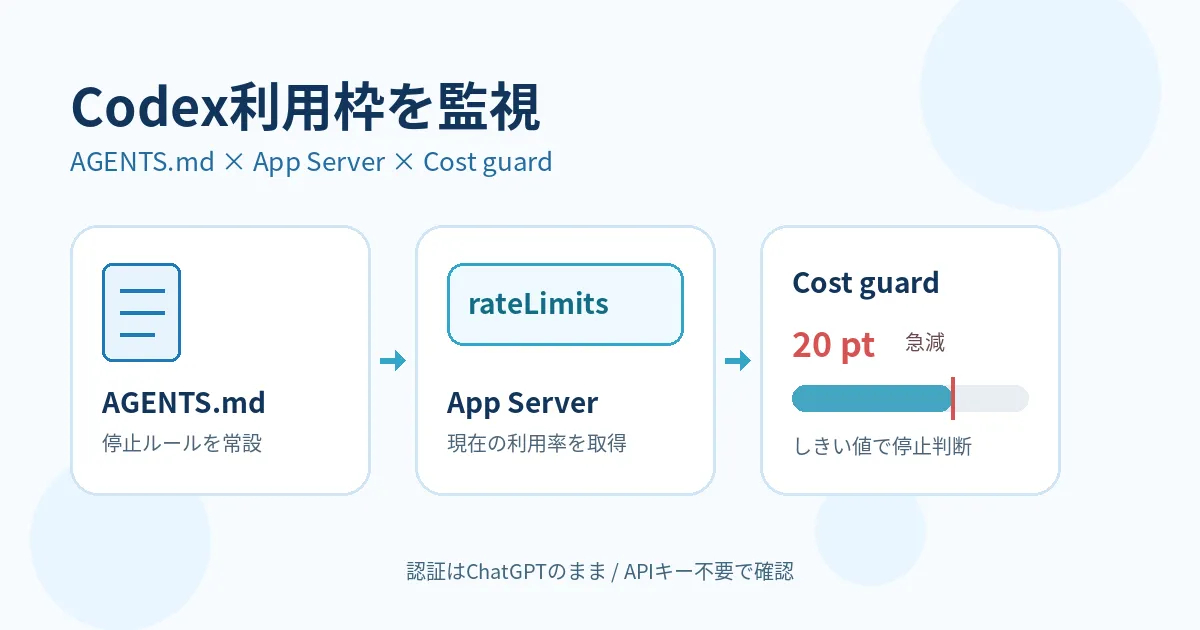
Codexの長時間処理で利用枠を急速に消費したときに止めたい。AGENTS.mdへCost guardを書き、最初の試行では残量を取得できず、Codex App Serverのaccount/rateLimits/readで5時間枠と週次枠を読めるところまで確認した。Ralph loopとの組み合わせも記録する。
Codex CLIの認証をChatGPTに固定する―forced_login_methodでAPI認証経路を制限する
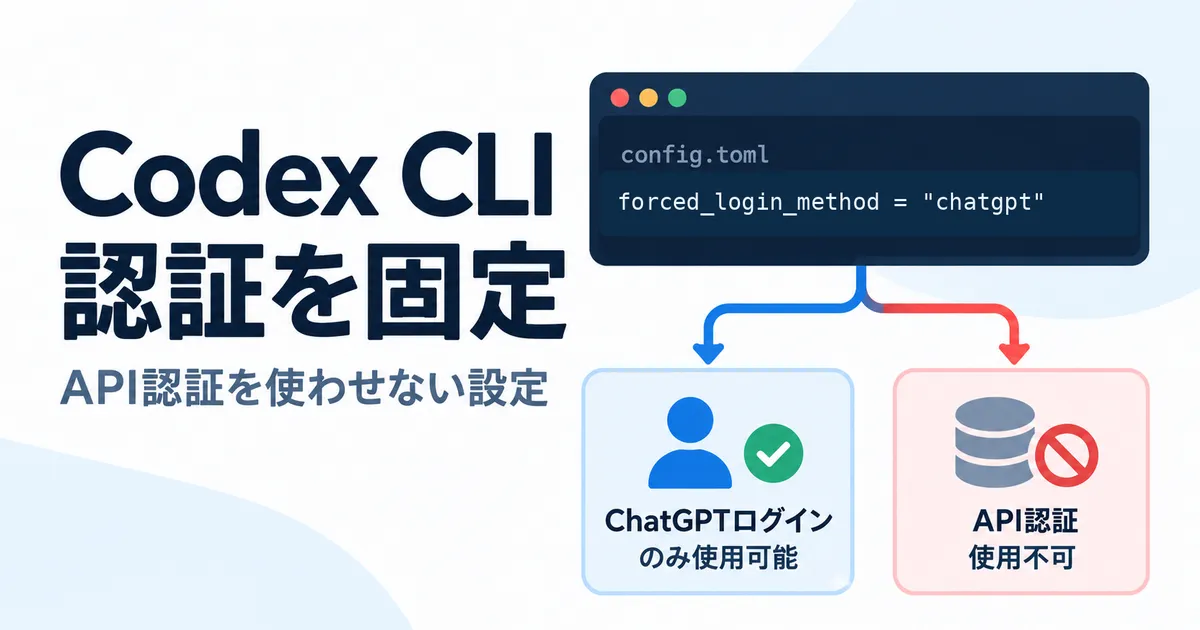
Codexの上限到達後にOpenAI API側の利用が発生していたというコメントをきっかけに、forced_login_method = "chatgpt" の役割を公式情報で確認しました。ChatGPT側の利用枠、API課金、AGENTS.md、環境変数との違いまで丁寧に説明します。
Gemini・Claude・Codexを連携する方法|ブログ運営をAIで分担する全体設計
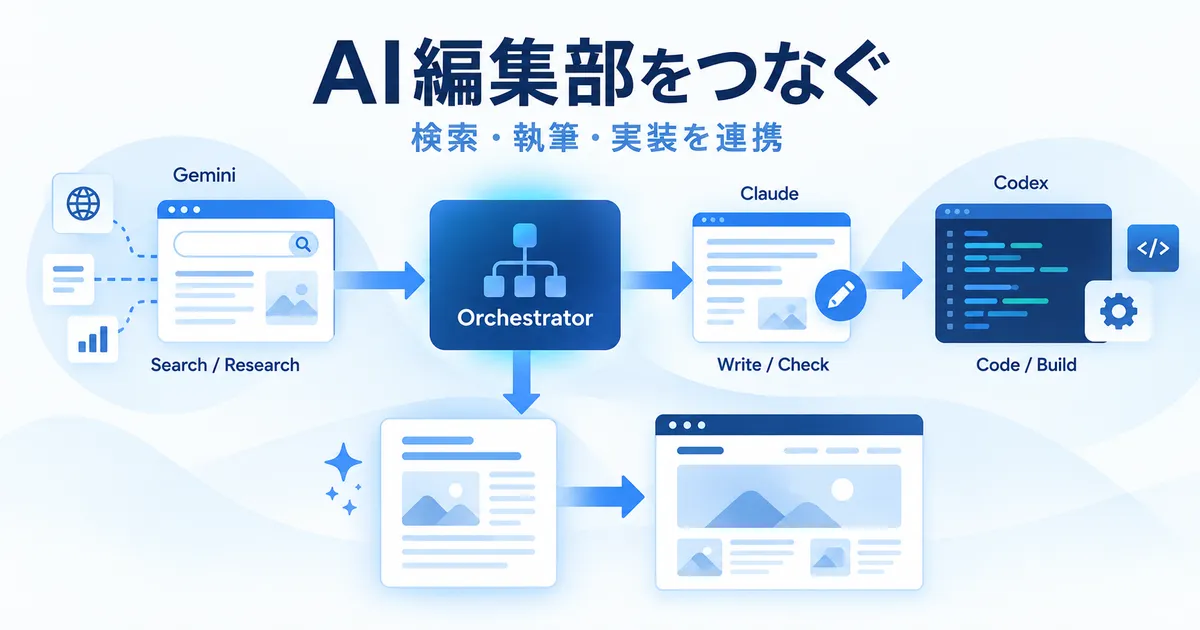
新連載「オーケストレーション実践」の第1回。Geminiに調査、Claudeに執筆、CodexにAstro実装を分担し、検索・記事生成・ファクトチェック・公開承認・分析までを複数AIで連携する全体設計を具体化する。