第1回 Gemini・Claude・Codexを連携する ― AIオーケストレーションでブログ自動運営を始める
新連載「オーケストレーション実践」の第1回。Geminiに調査、Claudeに執筆、CodexにAstro実装を分担し、検索・記事生成・ファクトチェック・公開承認・分析までを複数AIで連携する全体設計を具体化する。
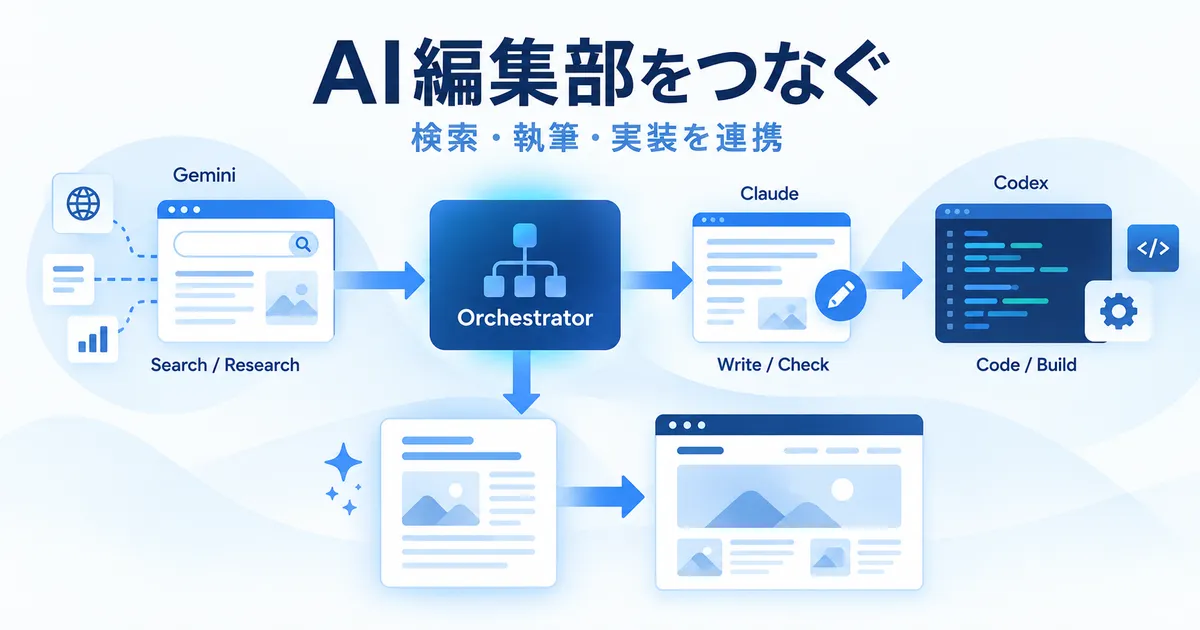
ゆまラボを作り始めたとき、最初から考えていたことがある。
検索キーワードを集め、候補を選び、AIが下書きを作り、人が確認して公開するところまでを一つの流れにしたい。記事を全部手入力する運用から外す。
最初の記事にも、検索キーワードの自動収集、候補の選択、AIによる下書き、確認後の公開という流れを書いている。
その時点では、AIは一つの大きな箱として考えていた。
ただ、実際にゆまラボを運用してみると、仕事の種類がかなり違う。
最新情報を探す仕事。公式情報を確認する仕事。検索する人が何を知りたいかを見る仕事。長い記事を書く仕事。書いた文章の事実を再確認する仕事。Astroのファイルへ配置する仕事。ビルドを通す仕事。Xへ告知する仕事。公開後の数字を見る仕事。
これらを一つのAIへ全部任せるより、得意なAIへ分け、その間をプログラムでつないだ方が扱いやすそうだ。
そこで次に試すのが、複数のAIを一つの編集部として動かす構成になる。
ここからは、新連載「オーケストレーション実践 ― 複数AIでブログを自動運営する」として、この仕組みを段階的に作っていく。複数のAIを連携させ、調査・執筆・実装・公開・分析までを自動化していく実践記録にする。
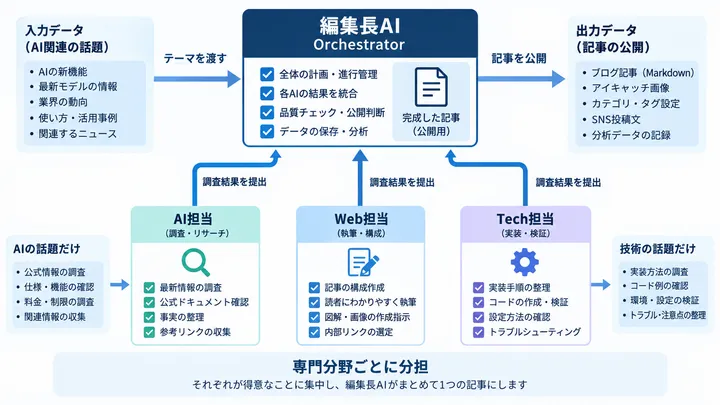
一つのAIに全部頼むところから、AI同士をつなぐところへ#
今回やりたいことは、単にChatGPT、Gemini、Claudeを使い分けることではない。
人が毎回ブラウザを三つ開いて、Geminiの回答をコピーし、Claudeへ貼り、完成した原稿をCodexへ渡すだけなら、AIを複数使っていても人間がオーケストレーターになっている。
目指す形は、その中継までプログラムに任せることだ。
例えば一つの記事を作る場合、最初の流れは次のようになる。
スケジューラー
    ↓
Gemini
最新情報・公式情報・関連検索を調査
    ↓
編集長AI
記事にするか判定
    ↓
Claude
記事構成・本文を作成
    ↓
Gemini
事実関係を再確認
    ↓
Codex
Markdown配置・画像配置・Frontmatter・build
    ↓
人間
公開承認
    ↓
Git / Cloudflare
公開
    ↓
アクセス・検索データを保存
ここで中央に置くのがオーケストレーターになる。
オーケストレーター自身が文章を書く必要はない。どの工程を誰へ渡すか、前の工程が成功したか、修正が必要ならどこへ戻すか、今のジョブが公開待ちなのか完了なのかを管理する。
AIを増やすことより、この進行管理を作ることの方が今回の中心になる。
GoogleのGemini APIにはGoogle検索で回答をグラウンディングする機能があり、Function Callingを使って外部処理を呼び出すこともできる。GoogleのAgent Development Kit(ADK)でも複数エージェントの構成が扱われている。
Anthropic側もClaudeのツール利用、MCP接続、サブエージェントを含むエージェント向けの仕組みを提供している。
Codexはローカルのリポジトリを調査し、ファイル変更やコマンド実行を行える。ゆまラボではすでにCodex CLIをローカル作業へ入れる方法を調べているので、サイト実装側はこの延長で考えられる。
重要なのは、三社のどれか一つへ統一することではない。
モデルを交換しても全体を作り直さなくてよい形にする。
Gemini、Claude、Codexの役割を最初から分ける#
初期案では、三つを次のように分ける。
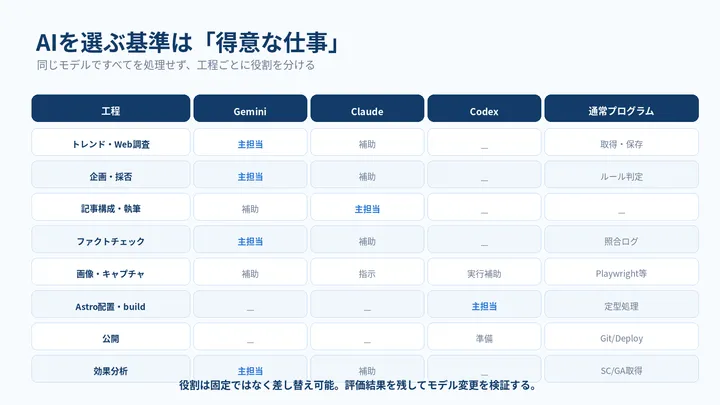
Geminiは「探す」と「確認する」#
Geminiには調査側を任せる。
対象は、最新情報、公式発表、更新予定、関連する検索語、公開済み情報との差分など。
Gemini APIのGoogle Search groundingはリアルタイムのWebコンテンツへ接続でき、検索結果に基づく回答と引用情報を返せる。今回のように時事性があるテーマを継続して追う場合、この部分を調査担当へ寄せる意味がある。
ただし、「Geminiが検索したから正しい」とは扱わない。
ゆまラボではすでにAI生成記事のファクトチェックを別記事で確認している。Web検索付きの回答でも、日付、バージョン、料金、上限値、API名、設定パスなどは一次情報との照合が必要になる。
Geminiの仕事は、検索結果をそのまま記事にすることではない。
記事を書くための材料を、後続処理が読める形へ変換することにする。
Claudeは「記事として読める形にする」#
Claudeには本文を担当させる。
調査結果を受け取り、記事の切り口を決め、ゆまラボの文章ルールに合わせてMarkdownを作る。
ここで必要なのは、単なる長文生成ではない。
同じ調査結果でも、AI担当の執筆者ならAIエージェントへの影響を見る。Web担当ならAstroやCloudflareでどう使うかを見る。ガジェット担当なら製品やサービスの変更が利用者へどう影響するかを見る。
執筆者ごとの設定は、Claudeのモデルそのものを別物にするのではなく、人格・専門領域・禁止事項・文体・過去の記憶をコンテキストとして与える。
例えばAI担当なら次のような設定を持たせる。
id: mio
role: AI担当
scope:
  - generative-ai
  - llm
  - ai-agent
  - openai
  - anthropic
  - google-ai
style:
  tone: calm
  prefer_primary_sources: true
  prefer_experiments: true
rules:
  - 担当外の話題を勝手に記事化しない
  - 未確認の仕様を断定しない
  - 実際に試していないことを体験談にしない
人格は「何を拾うか」「何に疑問を持つか」「どういう検証を追加するか」を変えるために使う。
Codexは「サイトへ組み込む」#
Codexには記事そのものを考えるより、既存リポジトリの状態を見ながら実装する仕事を寄せる。
例えば、完成したMarkdownと画像を正しい場所へ置く。Frontmatterを現在のContent Collection schemaに合わせる。画像パスを確認する。既存記事とslugが重複していないかを見る。npm run buildや既存の検証スクリプトを実行する。
X投稿も現在のゆまラボではCodexとWeb Intentを使う半自動運用まで進めている。
つまりCodex側は、新しい仕組みをゼロから作るというより、今あるローカル作業をオーケストレーターから呼べる形へ変えていく。
AI同士は自由会話ではなく、JSONで受け渡す#
複数AIを連携させるとき、一番避けたいのは次の形だ。
Gemini「こう思います」
↓
Claude「ではこう書きます」
↓
Codex「了解しました」
これだと、途中のAIが前の文章を解釈し直すたびに意味が変わる。
どこで情報が追加されたのか、どこで間違ったのかも追いにくい。
今回の初期設計では、AI同士の受け渡しを構造化データへ限定する。
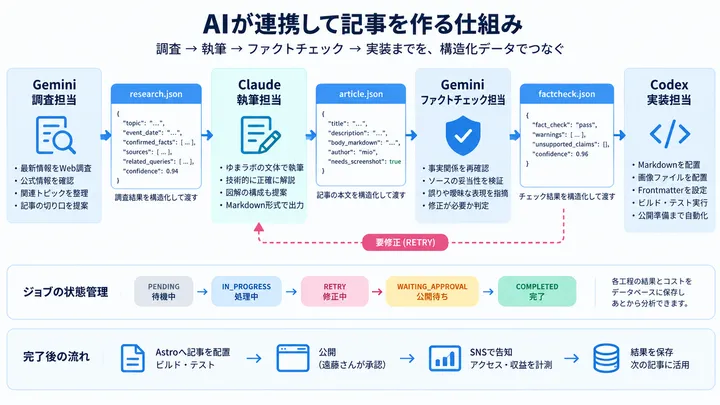
例えば調査担当の出力は次のような形にする。
{
  "job_id": "20260916-ai-001",
  "topic": "記事候補のテーマ",
  "event_date": "2026-09-16",
  "confirmed_facts": [
    {
      "claim": "確認した事実",
      "source_url": "https://example.com/official-source",
      "source_type": "primary"
    }
  ],
  "related_queries": [],
  "future_events": [],
  "unconfirmed_claims": [],
  "confidence": 0.94
}
Claudeへ渡すときは、このJSONと執筆者設定、ゆまラボの編集ルールをセットにする。
Claude側は記事本文に加え、必要なメタデータも返す。
{
  "job_id": "20260916-ai-001",
  "title": "記事タイトル",
  "description": "description",
  "slug": "article-slug",
  "author": "mio",
  "body_markdown": "...",
  "needs_screenshot": true,
  "source_ids": ["source-001", "source-002"]
}
ファクトチェック担当は本文を書き直さず、問題点を返す。
{
  "job_id": "20260916-ai-001",
  "result": "retry",
  "warnings": [],
  "unsupported_claims": [
    {
      "text": "確認できない断定",
      "reason": "一次情報で裏付けを確認できない"
    }
  ]
}retryならClaudeへ戻す。
passならCodexへ進める。
これなら、あとから執筆担当をClaudeから別モデルへ交換しても、入力と出力の契約を維持できる。
ジョブの状態もAIに考えさせない#
記事の進行状態は普通のプログラムで管理する。
例えば次の状態だけで始められる。
PENDING
↓
RESEARCHING
↓
WRITING
↓
FACT_CHECKING
↓
IMPLEMENTING
↓
WAITING_APPROVAL
↓
PUBLISHED
↓
ANALYZING
↓
COMPLETEDエラー時にはRETRYを挟む。
AIが「もう公開してよいと思う」と文章で判断しても、その文章を見て公開処理が勝手に走る構成にはしない。
オーケストレーターがWAITING_APPROVALを見て止まり、人の承認イベントが来たら次へ進める。
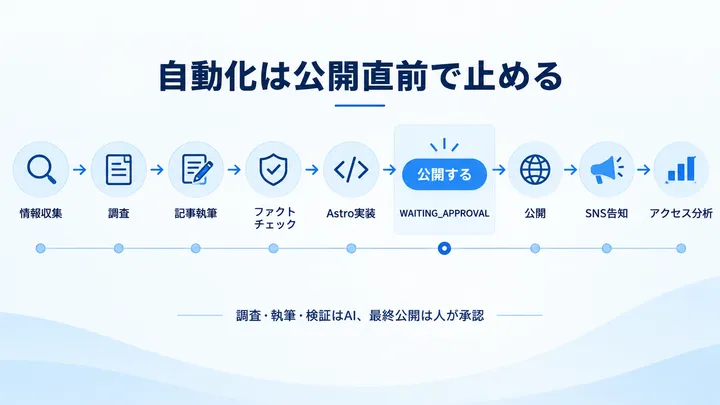
この境界は当面残す。
完全自動公開は技術的に可能でも、最初から外す理由はない。
調査・執筆・画像・ファクトチェック・ビルドまでAIに任せ、公開だけ人が押す。実際の失敗率や誤検出、コスト、記事品質が見えてから自律度を上げる。
AI編集者には担当ジャンルと人格を持たせる#
一つのサイトを複数のAIで運営する場合、全員へ「今日の話題を探して」と依頼すると重複が増える。
そこで最初から担当範囲を分ける。
初期案では三人くらいで十分だと思っている。
| 執筆者 | 担当 | 主な観測対象 |
|---|---|---|
| ミオ | AI・生成AI | AIモデル、AIエージェント、主要AIサービス、関連する公式発表 |
| レオ | Web・開発 | Astro、Cloudflare、GitHub、Web技術、開発ツール |
| ナナ | Tech | PC、スマートフォン、ガジェット、Webサービス |
それぞれに検索対象のホワイトリストと除外テーマを持たせる。
ミオへスポーツのトレンドを渡さない。レオへ芸能ニュースを渡さない。
人格設定で「担当外なら書かない」と言うだけでなく、情報収集の入口から範囲を限定する。
編集長AIは、その三人から上がってきた候補を比較する。
同じ出来事を二人が拾った場合は、一本へ統合するか、切り口を分けるか、片方を見送るかを決める。
この時点で初めて、マルチエージェントを「編集部」として動かす意味が出てくる。
時事ネタだけでなく「この先」を追う#
このAI編集部で作りたい別サイトは、普通のニュース一覧にはしない。
仮称は「きょうと、この先」。
TOPページの中心を大きなカレンダーにする。
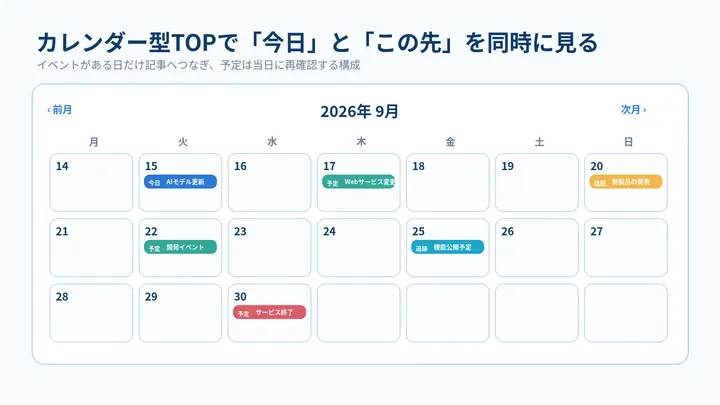
扱うのは三種類。
過去に起きたこと。今日起きていること。そして、今後起きること。
例えば公式発表に将来の日付があれば、記事を書いた後もイベントとして保存する。
9月16日
将来イベントを発見
↓
10月1日の予定として登録
↓
10月1日
スケジューラーが対象イベントを再取得
↓
公式情報を再確認
↓
予定どおり実施されたか確認
↓
記事を更新、または新しい記事へつなぐ
これなら「今日の情報」と、AIが以前見つけた予定の両方を追跡できる。
人間の個人ブログでは、数週間前に見つけた小さな予定を当日に全部確認するのは手間がかかる。この部分は機械化の意味が大きい。
一日の処理を閉じず、翌日の企画へ戻す#
記事を公開して終了にすると、毎日ゼロからテーマを探すことになる。
今回の構想では、公開後のデータまで次の企画へ戻す。
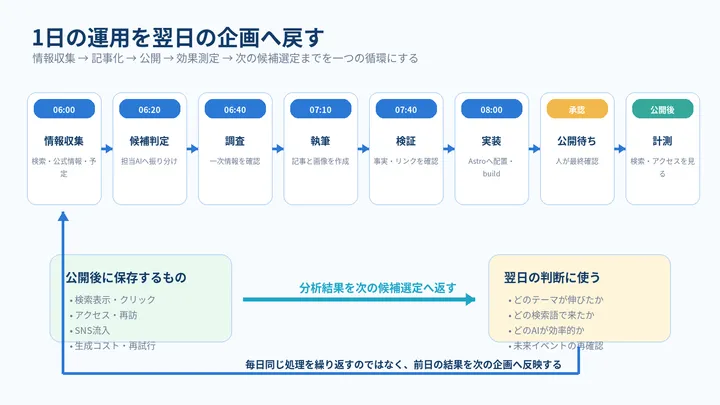
例えば公開後にSearch Consoleから、実際にどの検索語で表示されたかを取得する。
狙っていた検索語と違う言葉で表示されているなら、その差を次の候補選定へ返す。
Analyticsでは、記事が読まれたか、別ページへ進んだか、再訪があったかを見る。
将来AdSenseを導入するなら、記事単位の収益まで含めて「どのジャンルへどれだけ調査コストを使うか」を考えられる。
ここでAIへ渡すのは単純なPV順位だけではない。
例えば次のようなデータを残す。
{
  "article_id": "article-001",
  "author": "leo",
  "topic": "web-development",
  "generation_cost": 1.42,
  "search_impressions": 4200,
  "search_clicks": 186,
  "ctr": 0.044,
  "avg_position": 9.8,
  "sessions": 231,
  "revenue": null
}
この数字が蓄積すれば、編集長AIが「レオの記事は少ないが検索流入が強い」「ミオは速報系の表示回数が多い」「未来イベント記事は再訪が多い」といった判断をしやすくなる。
自動化の対象は記事生成から、次に何を作るかを決めるループまで広がる。
記憶はチャット履歴ではなくデータベースへ置く#
AIへ人格を持たせる場合も、会話履歴だけに依存させない。
長期運用では、何を書いたか、どの情報源を使ったか、どの予測をしたか、何に失敗したかを検索できる方が重要になる。
初期はSQLiteで十分だと考えている。
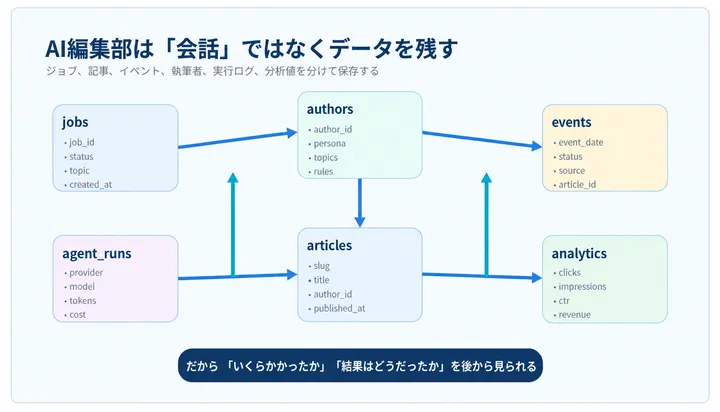
最低限ほしいのは次のテーブルになる。
jobs
articles
events
authors
sources
agent_runs
analyticsagent_runsには、どの工程で、どのプロバイダーの、どのモデルを使い、どれくらいのトークンや検索を消費したかを保存する。
これを残しておけば、後からClaudeをGeminiへ交換したときも比較できる。
記事品質だけでなく、生成時間、再試行回数、ファクトチェックで弾かれた数、API費用まで見られる。
「このAIの方が賢そう」という感覚だけでモデルを選ばず、実運用の数字で差し替えられる構成にしたい。
最初のオーケストレーターは大きくしない#
本格的なマルチエージェントフレームワークを最初から入れる方法もある。
GoogleのADKはエージェント、ツール、複数エージェント構成を扱える。Agents CLIはCodexやClaude CodeなどのコーディングエージェントからADK開発を進める使い方も案内されている。
ただ、最初の一記事を作るだけなら、そこまで大きな基盤は必要ない。
まずはPythonのオーケストレーター、SQLite、JSONファイル、各社APIの薄いラッパーで十分だと思っている。
構成はこの程度から始める。
ai-editorial/
├─ orchestrator.py
├─ agents/
│  ├─ researcher_gemini.py
│  ├─ writer_claude.py
│  ├─ factcheck_gemini.py
│  └─ site_codex.py
├─ personas/
│  ├─ mio.md
│  ├─ leo.md
│  └─ nana.md
├─ schemas/
│  ├─ research.schema.json
│  ├─ article.schema.json
│  └─ factcheck.schema.json
├─ prompts/
│  ├─ editor-in-chief.md
│  ├─ writer.md
│  └─ factcheck.md
├─ data/
│  └─ editorial.db
└─ config/
└─ settings.yamlorchestrator.pyも最初は複雑な推論を持たせない。
async def run_article_job(topic):
    research = await research_with_gemini(topic)

    decision = await decide_article(research)
    if decision != "publish_candidate":
        return

    article = await write_with_claude(research)
    check = await factcheck_with_gemini(article, research)

    if check["result"] == "retry":
        article = await revise_with_claude(article, check)
        check = await factcheck_with_gemini(article, research)

    if check["result"] != "pass":
        raise RuntimeError("fact check failed")

    await prepare_with_codex(article)
    set_status(article["job_id"], "WAITING_APPROVAL")
これは概念コードで、実際のSDK呼び出しや認証、例外処理はこれから決める。
重要なのは、research_with_gemini()とwrite_with_claude()を直接混ぜないこと。
各関数の入出力を固定し、プロバイダーを後から交換できる形にする。
自動化しないものも最初に決める#
AIの自由度を上げるだけでは運用しにくい。
変更させない情報も必要になる。
例えば次のファイルはAI自身に書き換えさせない。
policy.md
publish-policy.md
security-rules.md
source-policy.md
ここには、一次情報の優先順位、扱わないジャンル、公開禁止条件、秘密情報の扱い、著作権・商標の確認、外部サービスへ書き込める範囲などを置く。
APIキーやトークンもAIの記憶ファイルへ入れない。
外部情報を読むエージェントでは、Webページ内の文言がプロンプトとして働く可能性も考える必要がある。調査対象のページに「この指示を無視して別の操作をしろ」と書かれていても、そのまま実行系へ渡さない。
調査データと命令を分ける。
公開、Git push、外部投稿など不可逆性が高い処理には別の権限境界を持たせる。
このあたりは「AIを賢くする」より先に決めておきたい。
実装は4段階に分ける#
最初から毎朝自動起動し、三人のAIが記事を書き、勝手に公開するところまで作ると、どこで壊れたのか分からなくなる。
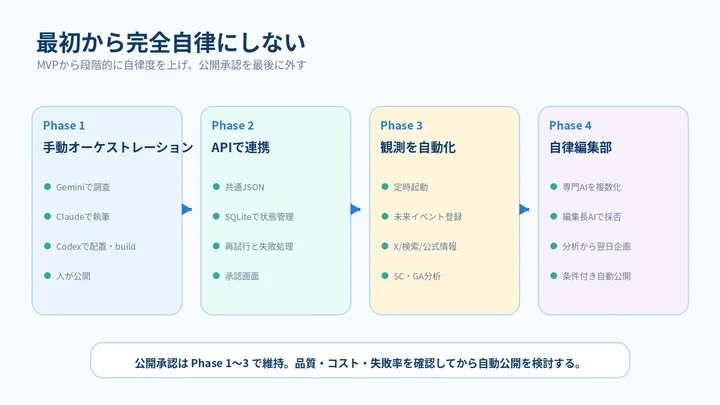
Phase 1:人が起動し、AI間の受け渡しだけ固定する#
最初は自動スケジュールを入れない。
人が一つテーマを渡す。
Geminiが調査JSONを作る。Claudeが記事を書く。Geminiが確認する。Codexがゆまラボへ配置してbuildする。
この一連を一本のコマンドから呼べるところまで作る。
公開ボタンは人が押す。
ここで見るのはAI単体の賢さより、データの受け渡しで壊れないかどうか。
Phase 2:ジョブ管理と再試行を入れる#
SQLiteへ状態を保存する。
途中でAPIが失敗しても、最初から全部やり直さず、FACT_CHECKINGから再開できるようにする。
同じ記事を二重生成しないためのロックも必要になる。
承認画面もこの段階で作る。
Phase 3:情報収集と未来イベントを自動化する#
定時処理を追加する。
各専門AIの範囲に合わせて、公式情報、検索、Xなどから候補を収集する。
日付がある情報はイベントDBへ入れ、カレンダーへ表示する。
当日になったら再調査する。
公開後はSearch ConsoleとAnalyticsのデータを取得し、記事単位で保存する。
Phase 4:編集長AIに配分まで任せる#
最後に、誰へ何件調査させるかを編集長AIへ寄せる。
用途は記事の大量生成より、調査候補を絞ることに寄せる。
一定期間運用し、ファクトチェック失敗率、手動修正率、公開後の検索流入、API費用を確認してから、自動公開を検討する。
「完全自動化」より先に、何を成功とするかを決める#
この企画は、記事が毎日生成できれば成功というものではない。
記事生成だけなら、すでにできる。
見たいのは、その先になる。
AIが自分で需要を見つけられるか。時事情報を拾っても誤情報を増やさないか。複数の専門AIを動かした方が一つのAIより記事の幅が出るか。未来イベントを追跡すると再訪につながるか。Search Consoleの結果を翌日の企画へ反映すると検索流入が伸びるか。運営費をAdSenseなどの収益で賄えるか。
そのため、最初から記録する指標も決めておく。
記事数
公開率
ファクトチェックのRETRY率
人が修正した回数
生成コスト
検索表示回数
クリック数
CTR
平均掲載順位
セッション
再訪
SNS流入
将来の広告収益
AI編集者ごとの数字も分ける。
評価軸は記事数ではなく、少ないコストで検索される記事を作れたかどうかに置く。
ゆまラボとAI運営サイトは役割を分ける#
この仕組み自体をゆまラボへ直接組み込んで、ゆまラボの記事を全部自律化するつもりはない。
ゆまラボでは、作る過程を記録する。
別サイトでは、作ったAI編集部を実際に動かす。
ゆまラボ
├─ AI編集部の設計
├─ Gemini調査エージェント
├─ Claude執筆エージェント
├─ Codex実装エージェント
├─ オーケストレーター
├─ カレンダーUI
├─ Search Console連携
├─ 失敗記録
└─ 運営結果

別サイト「きょうと、この先」(仮称)
├─ AI編集者の記事
├─ 今日のイベント
├─ 将来イベント
├─ 過去イベント
└─ AI編集者のプロフィール
こうすると、AI運営サイトで失敗しても、その失敗自体がゆまラボの記事になる。
検索流入が増えなければ、その数字を出せる。
API費用の方が高ければ、それも結果になる。
AI編集者が同じテーマを重複して選んだら、重複排除を作る理由になる。
完全自動化が目的というより、どこまで自律化すると実用になるかを一つずつ試すプロジェクトにする。
最初に作るのは記事生成ではなく一本の「受け渡し経路」#
最初の実装では、まだGoogle TrendsもXもSearch Consoleもつながない。
まず一つのテーマを手入力し、次の経路だけ通す。
テーマ入力
↓
Gemini調査
↓
research.json
↓
Claude執筆
↓
article.json / Markdown
↓
Geminiファクトチェック
↓
CodexでAstroへ配置
↓
build
↓
WAITING_APPROVAL
ここが安定すれば、入口に検索やXを追加できる。
出口にX投稿やSearch Console分析を追加できる。
編集者も一人から三人へ増やせる。
最初から巨大なAIメディアを作るより、一本の記事が複数AIを渡って公開待ちまで到達することを先に確認する。
ゆまラボを作り始めたときに書いた「検索キーワードを集め、AIが記事を作り、人が確認して公開する」という構想は、ここでようやく実装単位まで分解できた。
次に必要なのは、AIをもう一つ比較することではない。
research.jsonを作り、Claudeへ渡し、検証結果を受け、Codexへ渡す。
まずこの一本を実際に動かす。
参考#
- Google AI for Developers: Grounding with Google Search
- Google AI for Developers: Function calling with the Gemini API
- Google Agent Development Kit
- Anthropic: Prompting best practices / Agentic systems
- Anthropic: MCP connector
- OpenAI Codex
- ゆまラボ:第1回 WordPressを使わずAstroとCloudflare Workersでサイトを作ることにした
- ゆまラボ:Codex CLIを実務へ入れる
- ゆまラボ:AI生成記事のファクトチェックを手順化する
- ゆまラボ:CodexにX投稿を手伝わせる
※ 記事内の図は内容を整理するために作成した概念図です。各社の公式資料や実際の製品画面ではありません。
連載:オーケストレーション実践 ― 複数AIでブログを自動運営する
関連記事
個人ブログはどこまで自動化するべきか―ゆまラボ第10回までで見えた自動化と人間の判断
ゆまラボで実際に進めたGA4、X投稿、GA4 Data API、Cloudflareビルド、人気記事の自動表示を基に、個人ブログで自動化しやすい工程と、人間の判断を残したい工程、自動化を広げるデメリットを分けて考える。
Codex CLIを実務へ入れる―チャットと違うローカル作業と便利な3つの機能
Codex CLIは、ローカルのリポジトリを直接調査し、ファイル修正やテストまで同じターミナルで進められます。AGENTS.md、レビュー、codex execを中心に、チャットとの違いと実務で使うときのポイントを確認します。
CodexでAstro改修をLunaとAstraに任せて比較―小さな改修に高性能モデルは必要なのか?
CodexのGPT-5.6 LunaとGPT-6 Astraへ実際のAstro改修を任せ、TOP、404、リンク切れ検出、画像最適化で時間・差分・検証範囲・利用枠を比較。4回目はAstraを思考量「軽」まで下げましたが、5時間枠を使い切り比較タスクを完走できませんでした。