AI生成記事のファクトチェックを手順化する―Web検索比較で見えた確認箇所と編集方法
ChatGPTとGeminiのWeb検索比較で見つかったバージョン、上限値、API名、設定パスのずれを材料に、AI生成記事を公開前に確認するファクトチェックと編集の手順をまとめます。
AIで記事の下書きを作ると、文章そのものはかなり速くできる。
問題は、その文章がそのまま公開できる状態とは限らないこと。
特に技術記事では、文章全体の方向は合っているのに、バージョン番号だけ古い、制限値だけ違う、すでに削除されたAPIが混ざる、といったズレが起きる。
ゆまラボでは、ChatGPTとGeminiへ同じ3問を送り、Web検索の有無で回答がどう変わるかを比較した。
そこで確認できたのは、「Web検索を使えば全部正しい」「検索しなければ全部間違う」という単純な差ではない。
正しい説明の中に1つだけ古い仕様が混ざることもある。出典らしき表示があっても現在の公式情報と一致しないこともある。逆に、確認できない情報を無理に断定しない回答もあった。
AI生成記事を公開前に確認するなら、文章を最初から全部読み直すだけでは足りない。
外部確認が必要な主張を先に拾い、一次情報と照合し、確認できた範囲に文章を修正する。
今はこの順番で見るようにしている。
最初に「確認が必要な文」だけを抜き出す#
AIが生成した3,000字や5,000字の記事を、すべて同じ強さでファクトチェックする必要はない。
先に危ない箇所を分ける。
技術記事なら、少なくとも次のような情報は外部確認の対象にする。
| 種類 | 例 | 確認先 |
|---|---|---|
| 最新情報 | 最新版、リリース日 | 公式リリース、公式リポジトリ |
| 数値 | 無料枠、料金、上限値 | 公式料金表、Limits |
| 実装仕様 | API名、設定ファイル、オプション | 現在の公式ドキュメント |
| 廃止情報 | deprecated、削除済み機能 | Upgrade Guide、Changelog |
| 製品挙動 | 検索する、引用する、自動実行する | 提供元の公式ヘルプ |
| 実体験 | 実行時間、エラー、成功した操作 | 自分のログ、スクリーンショット |
ここで分けておくと、確認作業がかなり短くなる。
例えば、
AstroはContent Collectionsを使える。という説明は比較的安定している。
一方、
2026年9月11日時点のAstro最新版は○○。は時間で変わる。
通常のMarkdownはAstro.glob()で取得する。は具体的なAPI名なので、現在も使えるか確認が必要になる。
AIへ下書きを作らせた後、別の依頼で次のように抽出させてもよい。
この原稿から、公開前に外部情報で確認すべき断定だけを抜き出してください。

対象:
- バージョン
- 日付
- 料金
- 制限値
- API名
- 設定ファイル名
- 非推奨・削除済み機能
- 製品やサービスの現在仕様

本文の修正はまだ行わず、
「原文」「確認項目」「推奨する一次情報」の3列で出してください。
この段階ではAIに正誤判定まで任せない。
先に「何を確認するか」を出す。
最新版の質問では、断定しない回答も残す#
前の比較で差が大きかったのがAstro最新版の質問。
2026年9月10日時点の最新安定版、リリース日、変更点を聞いた。
ChatGPTの通常回答はAstro 7.3.2。
Web検索を使わないよう明示した回答では、最新安定版を内部知識だけで確定できないとして、具体的な番号を出さなかった。
Geminiの通常回答はAstro 6.0。
検索しないよう指示した条件ではAstro 7.3と回答し、画面には外部参照の表示も出ている。
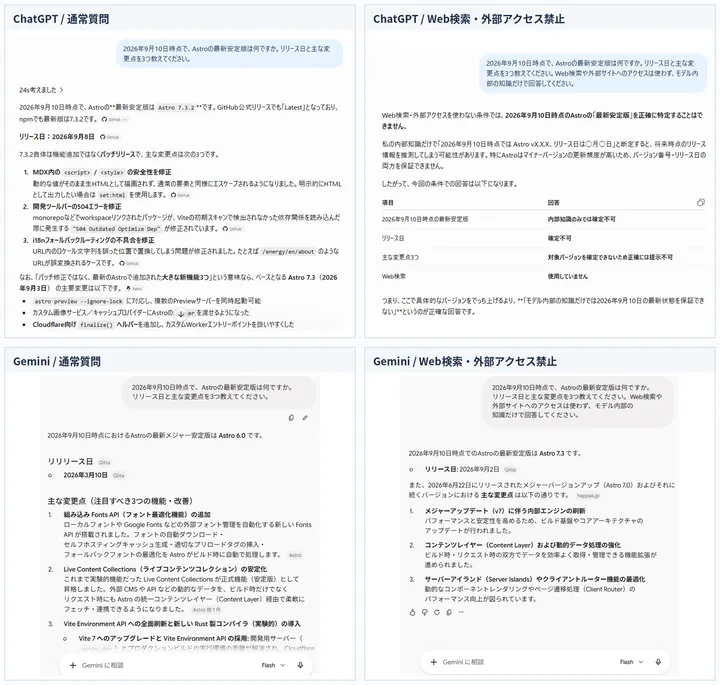
この例で編集時に残したいのは、詳しく答えた回答ではなく、確認できないものを確定しない姿勢の方になる。
最新版を特定できないなら、
最新版は7.3.2です。と推測で埋めるより、
最新版は公式リリースまたはパッケージ情報を確認してください。の方が安全。
記事ではさらに一歩進めて、公式情報を確認してから日付付きで書く。
2026年9月11日時点では、公式の○○で最新版が7.3.2と確認できる。こうすると、後から仕様が変わったときにも「当時の情報」として読める。
AIが自信を持っているかどうかは、確認基準にしない。
OpenAI自身も、ChatGPTは誤った情報を自信があるように提示する場合があり、重要な情報は信頼できる情報源で確認するよう案内している。
出典が付いていても、その文を裏付けているかを見る#
Web検索付きのAIは出典を表示できる。
ただ、出典の有無と本文の正確さは同じではない。
Cloudflare Workers Freeの比較では、Geminiの通常回答に、
100,000リクエスト/日
10ms CPU
50 Subrequests
が出た。
この3つは現在のCloudflare公式Limitsと一致する。
一方、同じ回答の補足にはCron Triggersについて「1つのWorkerにつき最大3つ」という記述が混ざった。
2026年9月11日時点のCloudflare公式Limitsでは、Workers FreeのCron Triggersは1アカウントあたり5。
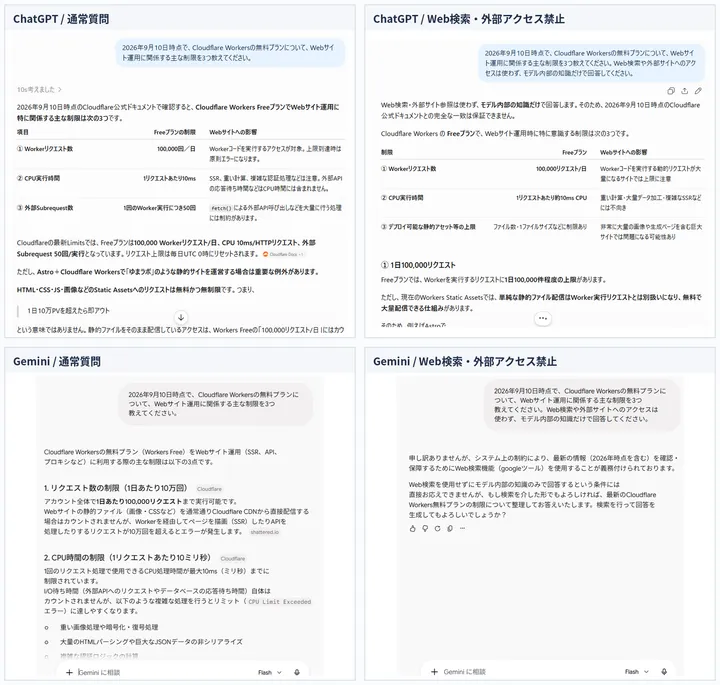
このような回答は少し厄介。
大部分が合っているため、そのまま読んだときに細かい誤りを見落としやすい。
ファクトチェックでは、回答単位ではなく主張単位で見る。
100,000 requests/day
→ 公式Limitsで確認

10 ms CPU/request
→ 公式Limitsで確認

50 subrequests/request
→ 公式Limitsで確認

Cron Triggers 最大3
→ 公式Limitsと不一致
出典ボタンがあるからOKにはしない。
リンク先を開き、そのページのどこが本文を支えているかを見る。
ChatGPT Searchの公式ヘルプにも、検索結果や引用が不完全、古い、誤っている場合があるため、引用元を開いて回答を裏付けているか確認するよう書かれている。
GoogleもGemini Appsについて、不正確な情報を事実として提示する場合があるので回答を再確認するよう案内している。
提供側の説明も、最終確認は利用者側で行う前提になっている。
API名と設定パスは文章より壊れやすい#
技術記事では、概念説明より具体的なコード周辺の方を強く見る。
前の比較でContent Collectionsについて聞いたとき、Geminiの説明には大筋で合っている部分が多かった。
型チェック、Frontmatterの検証、getCollection()などの説明は方向として問題ない。
ただ、通常回答にはAstro.glob()が出てきた。
Astro公式のUpgrade Guideでは、Astro.glob()はAstro 5で非推奨になり、Astro 6で削除されている。現在はContent CollectionsならgetCollection()、その他のソースならimport.meta.glob()へ置き換える。
別の回答には、
src/content/config.tsという設定パスも出ていた。
現在のContent Collectionsでは、
src/content.config.tsを使う。
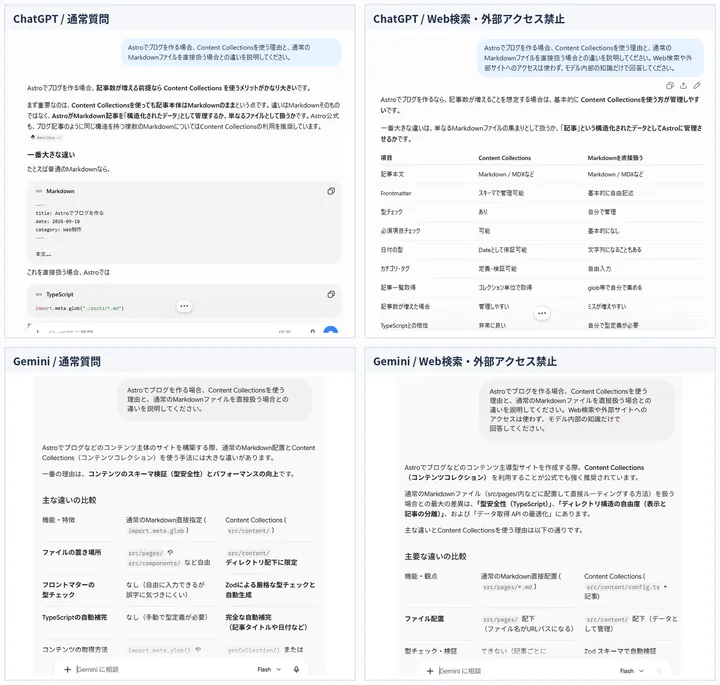
文章の説明が9割合っていても、読者がコピーする1行が古ければ技術記事としては困る。
特に確認するのは、
- import元
- 関数名
- CLIオプション
- ファイル配置
- 設定キー
- デフォルト値
- 非推奨になった方法
このあたり。
「仕組みは合っているから大丈夫」とは扱わない。
実装へ直結する文字列は個別に公式ドキュメントへ当てる。
ファクトチェック後は文章を「確認できた範囲」へ戻す#
事実確認が終わったあとに編集する。
ここでやるのは、単なる誤字修正ではない。
AIは情報が足りないところを自然な文章で埋めることがある。その補完部分を削る。
例えば、一次情報で「Freeは5個」としか確認できないのに、
Freeでは5個までなので、小規模運用ならほぼ問題ありません。と書いてあれば、後半は別の判断になる。
何を小規模とするか、どの運用なら十分なのかは公式Limitsからは分からない。
必要なら、
Workers FreeではCron Triggersを1アカウントあたり5個まで設定できる。
5個で足りるかは、定期処理の数を見て判断する。
まで戻す。
実測記事でも同じ。
Web検索を禁止したので、Geminiは検索していない。とは書けない。
実際の画面では、検索禁止を指定した回答にも外部参照チップが出たケースがあった。
なので、
Web検索を使わないよう指示した条件と表現する。
観測したことと、内部で何が起きたかの推測を分ける。
この修正は文章を弱くする作業ではない。
確認できた事実の範囲を明確にする作業になる。
AIに再チェックさせる場合も一次情報を固定する#
長い記事では、確認後の再チェックにもAIを使える。
ただし「この記事が正しいか確認して」だけでは、別の誤りを追加する可能性がある。
確認対象と参照先を絞る。
例えばCloudflareの記事なら、
以下の原稿を確認してください。

事実確認に使ってよい情報源:
- Cloudflare Workers公式Limits
- Cloudflare Workers公式Pricing

確認対象:
- 数値
- Free / Paidの区別
- 単位
- per request / per account / per Workerの違い

各主張を
SUPPORTED
CONTRADICTED
NOT FOUND
のどれかで判定してください。

原稿にない新しい仕様は追加しないでください。
という形。
この出力も最終回答にはしない。
CONTRADICTEDとNOT FOUNDを中心に、人間が元ページを確認する。
AIに一次情報を探させるところまでは任せられる。
最後の「この引用でこの断定を書いてよいか」は公開側で見る。
編集ではAIらしい文章より事実の境界を優先する#
ファクトチェックが終わっても、記事として読みづらければ公開しにくい。
AI生成文では、同じ説明を言い換えて繰り返したり、各章が同じ構造になったり、確認していない一般論を最後に足したりすることがある。
ここは普通の編集として削る。
自分が特に見るのは次の3つ。
確認していない一般化
1件のテスト結果から「AIは必ずこうなる」と広げていないかを見る。
前のChatGPTとGeminiの比較も3問だけなので、モデル全体の性能評価にはしていない。
実測と解釈の混在
「画面に外部参照が出た」は実測。
「内部で必ず検索した」は内部挙動の断定になる。
同じ段落で混ぜない。
出典から増えた形容
公式が「上限5」と書いているだけなのに、「十分」「安全」「大規模でも問題ない」まで足していないかを見る。
この削除だけで、AI生成文はかなり読みやすくなる。
AI生成記事は下書きから公開までを分ける#
ゆまラボでは、Markdownを作成してGitHubへ入れた後、Cloudflare Workersで公開できる構成になっている。
以前から、AIが生成した記事を即時公開せず、内容と出典を確認してからマージする流れを想定している。
ファクトチェックまで含めるなら、公開経路は次の形が扱いやすい。
テーマを決める
↓
AIで下書きを作る
↓
検証が必要な主張を抽出する
↓
一次情報で確認する
↓
誤り・不明確な断定を修正する
↓
文章を編集する
↓
画像・リンク・Frontmatterを確認する
↓
公開
AI生成コンテンツを使うこと自体がGoogle Searchで禁止されているわけではない。
Googleは、生成AIを調査やオリジナルコンテンツの構成に使えるとしている。一方、ユーザーへの価値を追加せず大量のページを生成し、検索順位の操作を主目的にする行為はscaled content abuseの対象になる。
公開前の確認を入れる理由は、AIを隠すためではない。
読者がそのまま使う可能性のあるバージョン、数値、設定、コードを、現在の情報に合わせるため。
前の比較では、Web検索付きでも誤りが残り、検索を使わない条件でも正しい説明が出る場面があった。
だから「検索ONなら公開」のような判定にはしない。
主張を抜き出す。
一次情報へ当てる。
確認できない断定を削る。
実測と推測を分ける。
この工程を通してから公開する。
AI生成記事の品質を上げる作業としては、この手順が一番再現しやすい。
参考#
- ゆまラボ「ChatGPTとGeminiで同じ3問を試す―Web検索の有無で回答はどこまで変わるか」
- OpenAI Help Center「ChatGPT は真実を伝えますか?」
- OpenAI Help Center「ChatGPT でウェブを検索する」
- Gemini Apps Help「Gemini アプリの回答について」
- Google Search Central「Google Search’s guidance on using generative AI content on your website」
- Cloudflare Workers Docs「Limits」
- Astro Docs「Upgrade to Astro v6」
関連記事
ChatGPTとGeminiで同じ3問を試す―Web検索の有無で回答はどこまで変わるか
ChatGPTとGeminiへ同じ3つの技術質問を送り、通常質問と「Web検索・外部アクセス禁止」の条件で回答を比較しました。Astro最新版、Cloudflare Workers Free、Content Collectionsを使い、最新情報と安定した技術知識で差を確認します。
ChatGPTでWebサイトの最新状態を確認する―検索結果と実ページ取得を分けて検証した記録
ChatGPTにゆまラボの公開状態を確認させたところ、TOP・記事一覧・検索経路で取得内容が一致しなかった。検索結果だけで最新と決めず、個別記事、sitemap、RSS、クエリパラメータ、Cache-Control付きHTTP取得まで分けて確認した記録。
ChatGPTで同じURLが見えたり見えなかったりする―Cache missとWeb検索を切り分ける
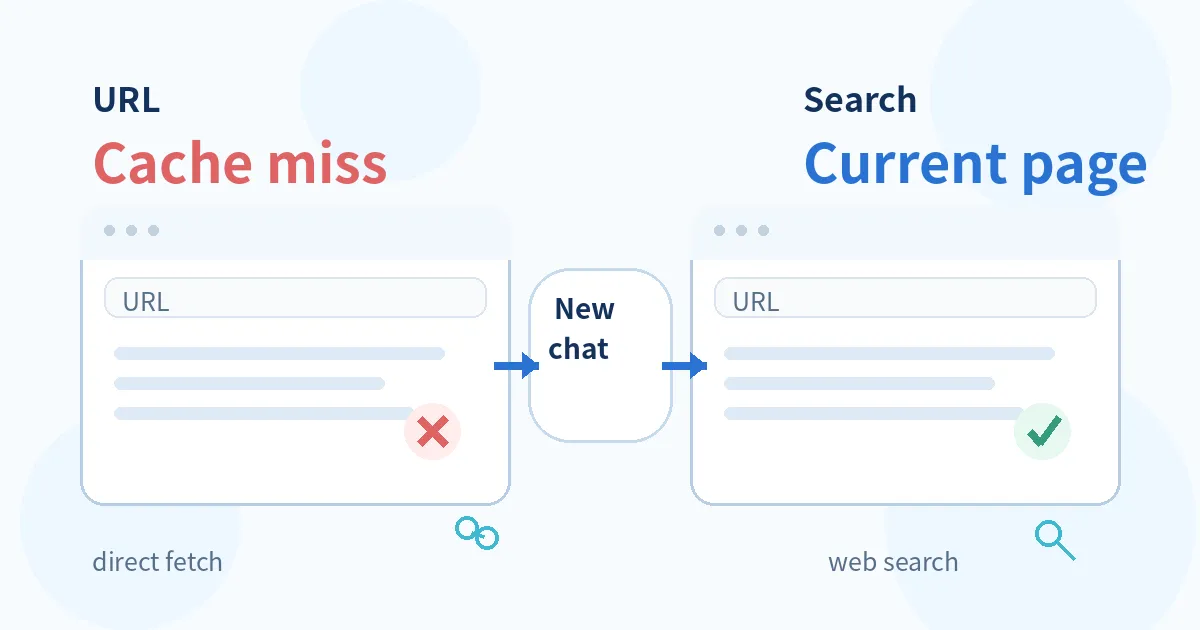
ChatGPTで公開サイトの評価を頼んだところ古い状態で回答され、同じチャットではURL直接取得がCache miss、新しいチャットでは取得できた。実際の画面を使い、会話コンテキスト、Web検索、検索結果の鮮度、URL直接取得を分けて確認する。