Web Searchとdeep researchをどう使い分けるか―速い検索と深い調査を比較する
ChatGPTのWeb Searchとdeep researchを、調査の深さ、速さ、情報源の扱い、向いている質問、使うときの注意点から比較する。ゆまラボでWeb検索を使ってきた実例も踏まえ、どこで切り替えるかを整理する。
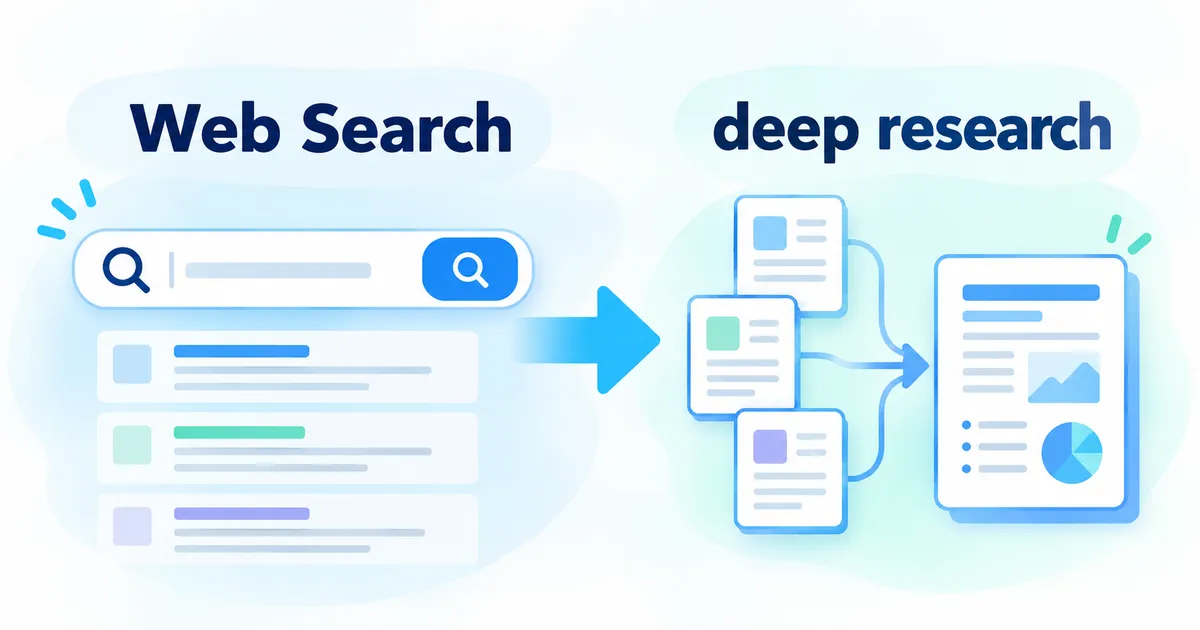
ChatGPTで最新情報を調べるとき、普通のWeb検索で十分なのか、deep researchまで使った方がよいのか迷う場面があります。短い事実確認なら検索で足りますが、複数の情報源を突き合わせて判断したい調査では、求める作業量が変わります。
ゆまラボでは、これまでChatGPTのWeb検索を使い、サイトの最新状態、技術仕様、料金や制限、AIサービスの情報を確認してきました。その中では、検索結果と実ページ取得で見える状態が食い違うケースもあり、検索結果をそのまま現在の事実として採用しない運用にしています。
この記事では、2026年9月時点のOpenAI公式情報と、これまでのWeb検索での実体験を基に、Web Searchとdeep researchの役割、向いている質問、デメリット、切り替え方を確認します。
Web Searchは「今知りたいこと」を短く確認しやすい#
ChatGPT Searchは、質問にウェブ上の情報が役立つ場合、自動で検索を使うことがある。ツールから検索を明示的に選ぶこともできる。
OpenAIの公式ヘルプでは、検索時にユーザーの質問を1つ以上の検索クエリへ書き換え、外部の検索プロバイダーへ送る場合があると説明されている。最初の検索結果を見たあと、より具体的な追加検索を行うこともある。
実際に使うと、この速さが大きい。
たとえば、次のような確認ならWeb Searchと相性がよい。
- 現在の製品バージョンを確認する
- 公式料金ページの最新価格を見る
- サポート期限を確認する
- 最近発表された機能を確認する
- 指定したサービスの公式ドキュメントを探す
- 公開サイトに特定の記事があるか確認する
ゆまラボでも、AIサービスやCloudflare、Astroなどの記事を書く前に、現在の仕様を確認する用途でWeb検索を繰り返し使っている。
一方、検索結果は「見つかった情報を短時間で集める」処理が中心になる。調査対象が広がるほど、情報源同士の関係や食い違いを自分で追加確認する場面が増える。
以前、ゆまラボ自身の公開状態をChatGPTで確認したときは、検索経路、トップページ、記事一覧で取得された最新日付が一致しなかった。さらにURL直接取得がCache missで止まるケースもあった。
この経験から、Web Searchを使うときは、検索結果の存在と現在の公開状態を分けて確認している。
関連する実測は、ChatGPTでWebサイトの最新状態を確認する―検索結果と実ページ取得を分けて検証した記録に残している。
deep researchは複数の情報源をまとめて判断する作業向け#
OpenAIはdeep researchを、複雑な質問について計画を作り、複数の情報源を調査し、出典付きの構造化レポートへまとめる機能として案内している。
Chatでは、開始前に調査計画案を確認できる。調査対象のWebサイトを指定したり、アップロードしたファイルを使ったり、利用可能な接続済みアプリを情報源に含めたりできる。調査中の進捗を確認し、途中で焦点を変更することも可能になっている。
この仕組みは、質問そのものが複数段階に分かれるときに使いやすい。
たとえば「現在の主要AI動画生成サービスを調べて」と頼むだけならWeb Searchでも情報は集められる。
ここへ、
- 日本で利用可能なサービスだけを対象にする
- 公式料金と利用制限を確認する
- 商用利用条件を比較する
- 同一人物を継続利用する機能を確認する
- 動画生成時間や出力条件を比べる
- 各社の公式情報が食い違う場合は差を説明する
- 最後に用途別の比較表へまとめる
といった条件が重なると、単発検索を何回もつなぐ必要が出てくる。deep researchは、この種類の調査を1つの調査計画として扱いやすい。
OpenAI自身も、簡単な事実確認には検索、深さや網羅性が必要な調査にはdeep researchという使い分けを案内している。
速さと調査量で見ると役割がかなり違う#
2つを使い分けるとき、機能名より「どこまで調べる必要があるか」で決める方が分かりやすい。
| 確認したいこと | Web Search | deep research |
|---|---|---|
| 最新バージョンを1つ確認 | 向いている | 調査量が多い |
| 公式料金を確認 | 向いている | 条件比較が多い場合に有効 |
| 最近のニュースを短く把握 | 向いている | 詳細な背景調査で有効 |
| 複数製品を同じ条件で比較 | 可能 | 向いている |
| 複数の情報源の食い違いを追う | 手動確認が増える | 向いている |
| 指定した資料とWebをまとめて分析 | 作業が分かれやすい | 向いている |
| 出典付きの長い調査レポート | 追加指示が必要 | 主用途に近い |
Web Searchは、質問と回答の往復を短く回せる。気になった部分だけ追加検索しやすく、調査方向をその場で変えやすい。
deep researchでは、最初に調査対象、制約、欲しい成果物をある程度決めるほど結果を使いやすくなる。質問が広いままだと、読む情報量も増えやすい。
deep researchのデメリットは「深く調べるコスト」がそのまま増えること#
deep researchは調査量を増やせる分、毎回使うと重い。
最初に出る差は時間。OpenAIも、緊急の回答が必要な場合は検索または標準チャットを使い、deep researchは詳細分析へ回す案内を出している。
短い質問で毎回deep researchを使うと、数十秒で足りる確認に対して、調査計画、複数情報源の確認、レポート作成まで含めることになる。
利用量にも制限がある。deep researchの利用可能回数はプランによって変わり、製品内の利用状況カウンターで残りを確認する仕様になっている。固定の月間枠があるプランでは、最初に使用した日から30日ごとにリセットされる。
もう1つは、調査範囲を広げるほど不要な情報も入りやすい点。
「動画生成AIの料金を知りたい」という質問に対して、市場規模、企業沿革、投資情報、競合史まで集めても、その後の判断には使わないことがある。deep researchでは、開始時に対象、除外条件、比較項目、最終成果物を具体的に指定した方が扱いやすい。
出典が付いていても、内容の確認は残る。公式ヘルプでも、完成したレポートは情報源が主張を支えているか確認するよう案内されている。
ゆまラボの記事作成でも、この点はWeb検索と同じ扱いにしたい。引用やリンクが付いていても、記事へ載せる仕様、料金、制限値は一次情報まで確認する。
Web Searchにも検索結果特有の弱点がある#
Web Searchは速い一方、検索経路から取得した情報が、対象ページの現在状態と完全に一致するとは限らない。
ゆまラボでは、2026年9月17日に同じサイトを確認した際、検索経路のトップ、最初に取得したトップ、記事一覧で見える最新日付が分かれた。
検索経路では古い状態が残り、記事一覧では新しい記事が取得できる。この状態で「検索結果に出た日付が現在のサイト状態」と決めると判断を誤る。
ChatGPT Searchでは、検索プロバイダーを使う場合がある。検索結果と、指定URLをその場で直接取得した結果は、同じ確認経路として扱わない方が安全だ。
また、検索は質問に応じてクエリを書き換える。便利な仕組みだが、自分が入力した文字列そのものだけで検索しているとは限らない。
技術調査で特定のエラー文字列や正式名称を追う場合は、検索対象を明示した方が結果を確認しやすい。
ゆまラボでは3段階で切り替える#
今の使い方なら、調査を3段階に分けると扱いやすい。
1. まずWeb Searchで事実を拾う#
最新版、料金、発表日、公式ドキュメントの場所など、答えが短いものは検索で確認する。
ここで十分なら調査を終える。
2. 比較条件が増えたら検索を重ねる#
2〜3サービスの比較や、公式ページ数件の確認なら、通常の検索を複数回使う方が速い場合が多い。
検索結果が食い違ったら、一次情報へ寄せる。公開サイトの現在状態を確認するときは、検索結果、個別ページ、サイトマップなど確認経路も分ける。
3. 調査項目が枝分かれしたらdeep researchへ切り替える#
比較対象が増え、情報源の優先順位、除外条件、複数資料の突き合わせ、長いレポートが必要になったところでdeep researchを使う。
この段階では「詳しく調べて」だけで始めず、調査項目を指定する。
たとえば、AIサービスを調査するなら、料金、利用上限、商用利用、入力形式、出力形式、対応言語、公式情報の更新日など、最初から比較軸を渡した方が後で読みやすい。
どちらを使うかは質問の長さより調査工程で決める#
短い質問でも、確認先が10社あり、料金、規約、対応地域まで調べるなら調査工程は長い。逆に、長い説明を求める質問でも、1つの公式ドキュメントを読めば答えられるならWeb Searchで足りる。
使い分ける基準は、検索語の数より、必要な情報源と比較工程の数になる。
Web Searchは、素早い確認と追加質問を繰り返す作業に向く。
deep researchは、調査計画を作り、複数の情報源を読み、比較し、出典付きレポートへまとめる作業に向く。
ゆまラボの記事作成では、普段の仕様確認をWeb Searchで行い、比較対象や確認項目が増えた調査だけdeep researchへ回す形が使いやすい。検索結果だけで判断せず、公開時に重要な事実は一次情報まで確認する方針も変えない。
参考#
関連記事
ChatGPTでWebサイトの最新状態を確認する方法|検索結果と実ページ取得の違いを検証
ChatGPTにゆまラボの公開状態を確認させたところ、TOP・記事一覧・検索経路で取得内容が一致しなかった。検索結果だけで最新と決めず、個別記事、sitemap、RSS、クエリパラメータ、Cache-Control付きHTTP取得まで分けて確認した記録。
ChatGPTで同じURLが見えたり見えなかったりする原因|Cache missとWeb検索を検証
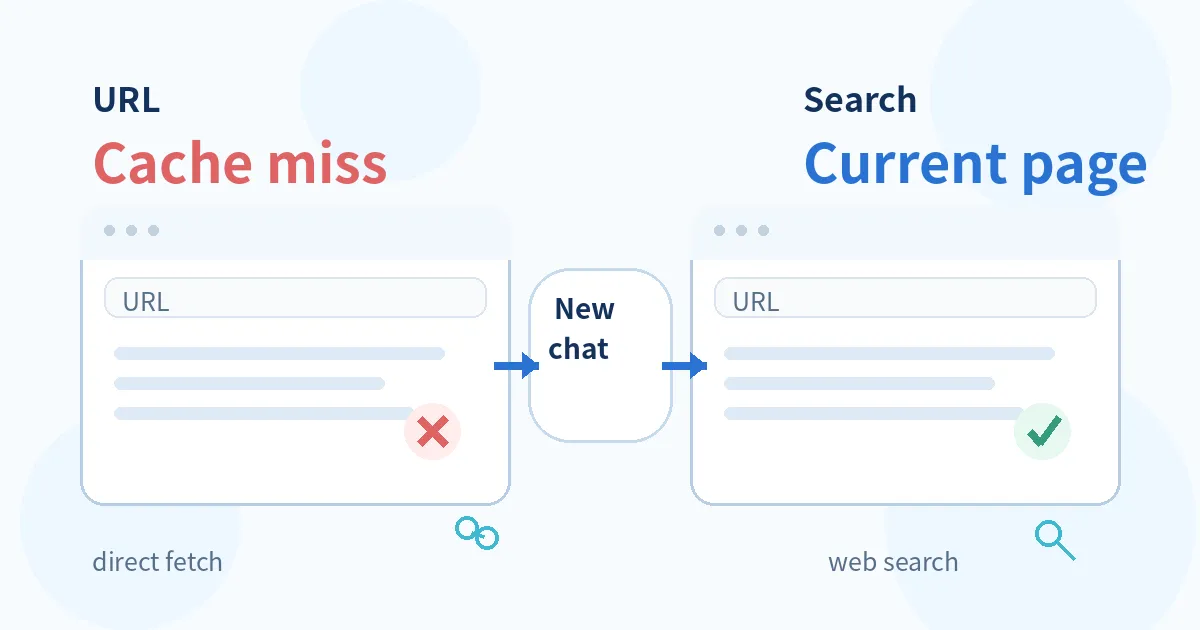
ChatGPTで公開サイトの評価を頼んだところ古い状態で回答され、同じチャットではURL直接取得がCache miss、新しいチャットでは取得できた。実際の画面を使い、会話コンテキスト、Web検索、検索結果の鮮度、URL直接取得を分けて確認する。
AI生成記事をファクトチェックする方法|公開前に確認する項目と編集手順
ChatGPTとGeminiのWeb検索比較で見つかったバージョン、上限値、API名、設定パスのずれを材料に、AI生成記事を公開前に確認するファクトチェックと編集の手順をまとめます。