ChatGPTでWebサイトの最新状態を確認する―検索結果と実ページ取得を分けて検証した記録
ChatGPTにゆまラボの公開状態を確認させたところ、TOP・記事一覧・検索経路で取得内容が一致しなかった。検索結果だけで最新と決めず、個別記事、sitemap、RSS、クエリパラメータ、Cache-Control付きHTTP取得まで分けて確認した記録。
Webサイトを更新した直後に、ChatGPTへ「今のサイトを見て最新記事を教えて」と頼む。
検索結果に新しい記事が出てくれば、それで確認できたようにも見える。ところが、サイト運営側で知りたい「現在公開されている内容」と、検索や取得機能から見える内容は必ずしも同じにならない。
2026年9月17日、ゆまラボ自身を対象に確認したところ、取得経路によって見える状態が分かれた。
最初にTOPページを取得したときは9月16日の記事が先頭。記事一覧では9月17日の記事が2件並んでいた。その後、検索経路からTOPを確認すると9月15日の記事が先頭として返り、URLを直接開く取得はCache missで止まった。
同じサイトについて、9月15日、9月16日、9月17日の状態が別々に見えている。
以前、ChatGPTで同じURLが見えたり見えなかったりする―Cache missとWeb検索を切り分けるでは、「URLを取得できるか」を中心に確認した。
今回は一段進めて、取得できた内容を「現在の状態」と判断してよいかを見ていく。
取得経路によって見えるTOPが変わった#
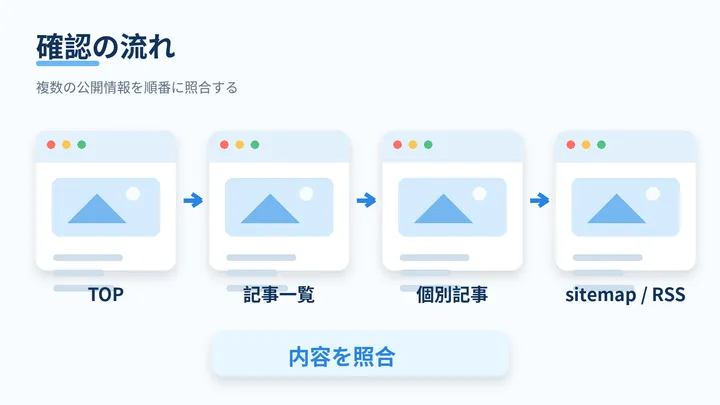
確認の手順を図にすると、途中で1つでも食い違いが出た時点で「最新確認済み」とは言えない。
最初に確認したのは次の2URL。
https://bringain.com/
https://bringain.com/blog/
最初のTOP取得では、新着・更新記事の先頭に2026年9月16日公開の「第8回 GA4 Data APIで記事別PVを取得する」が表示された。
同じ確認で記事一覧を取得すると、先頭は9月17日の記事。
1件目
第10回 人気記事を自動表示する―GA4のPV上位3件をゆまラボのTOPページへ反映
公開日:2026年9月17日

2件目
第9回 GA4 Data APIをCloudflareビルドで使う―サービスアカウントが使えずOAuthへ切り替える
公開日:2026年9月17日
記事一覧には81件と表示されていた。
ここでTOPと記事一覧が食い違う。
| 確認先 | 取得された内容 |
|---|---|
| TOPの最初のURL取得 | 9月16日の記事が先頭 |
| 記事一覧の最初のURL取得 | 9月17日の記事が先頭 |
| 記事一覧の表示件数 | 81件 |
この時点で、日付が新しい記事一覧を採用すれば「最新記事は9月17日」と答えられる。
ただ、それでは「記事一覧で新しい記事を見つけた」ことと、「TOPを含む現在の公開状態を確認した」ことが混ざる。
そこで新しい方を自動採用せず、取得経路を増やした。
再確認すると検索経路では9月15日が先頭#
記事を書き直す段階でもう一度検索したところ、検索経路から取得されたTOPはさらに別の状態を示した。
新着・更新記事の先頭は2026年9月15日の「GA4に自分のアクセスはどれくらい混ざるか―内部トラフィックの確認と除外方法」。
カテゴリ表示も、その取得結果では次の内容になっている。
AI 15件
- AIサービス 5件
- 画像生成 3件
- 開発支援 7件
つまり、同じ9月17日の確認中に少なくとも次の3種類が見えた。
検索経路のTOP
→ 9月15日

最初のTOP取得
→ 9月16日

記事一覧
→ 9月17日
「Crawled: yesterday」「Crawled: today」といった表示もあるが、日付表示だけでは3つの差を説明できない。
ここで原因をキャッシュと決めることもしなかった。
検索インデックス側の更新差、取得サービス側のキャッシュ、CDN側の状態など複数の可能性があり、この結果だけでは区別できない。
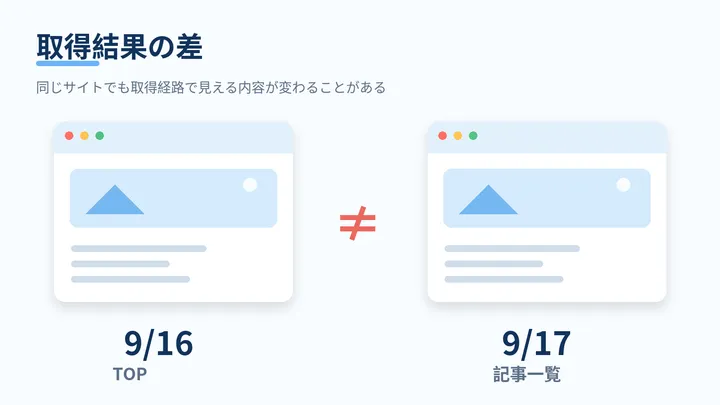
同じサイトでも、検索経路のTOP・最初のTOP取得・記事一覧で見える日付が分かれた。
URLを直接開く再確認はCache missで止まった#
TOP、記事一覧、カテゴリページをもう一度URL指定で直接開いた。
結果は次の形。
Failed to fetch https://bringain.com/: Cache miss

Failed to fetch https://bringain.com/blog/: Cache miss

Failed to fetch https://bringain.com/category/ai/: Cache miss
検索結果は返る。
一方、URL直接取得は失敗する。
この状態なら、検索結果を「直接ページを取得した結果」と読み替えることはできない。
OpenAIのChatGPT Search公式ヘルプでは、検索時に外部の検索プロバイダを使う場合があり、質問を1つ以上の検索クエリへ書き換えて送信する仕組みが説明されている。
つまり、ChatGPTの「Web検索」と「指定URLを直接取得する処理」は、少なくとも同じものとして扱わない方がよい。
検索でページ内容らしきものが返っても、
https://bringain.com/をその時点で直接取得できた証明にはならない。
今回のように、検索は結果を返し、URL直接取得はCache missになるケースが実際に出ている。
個別記事も取得できる時とできない時があった#
9月17日の記事一覧に表示された2記事は、最初の確認では本文まで取得できた。
対象URLはこちら。
https://bringain.com/blog/10-ga4-popular-posts-top-page/
https://bringain.com/blog/09-ga4-data-api-cloudflare-oauth/
本文側でも公開日は2026年9月17日として取得できていた。
ところが、その後の再取得では同じURLがInternal Errorになる場面もあった。
この差を、
最初に取れた結果が正しいあるいは、
後から失敗したので記事は存在しないとは判断しない。
残せる記録は次の内容。
記事一覧
→ 9月17日の記事情報を取得できた

個別記事
→ 本文まで取得できた経路がある
→ 再取得では Internal Error になる場合もある
ここでも、取得できた内容そのものと、現在性の判定を分ける必要が出た。
sitemap.xmlとRSSも確認対象にした#
TOPと記事一覧だけで判定しないため、別の公開データも確認する。
対象は次の2つ。
https://bringain.com/sitemap.xml
https://bringain.com/rss.xml
sitemap.xmlを取得できれば、記事URLが現在のサイトマップへ含まれているか確認できる。
RSSも、新着記事がFeedへどう出力されているかを見る材料になる。
ただし、今回の直接取得では本文確認まで進まなかった。
過去にサイトマップやRSSを設置していることは分かっている。それでも、
以前存在したと、
2026年9月17日の取得で内容を確認したは別。
取得できなかったものを過去の記録から補完すると、現在状態を確認する目的から外れる。
クエリパラメータを付けた取得#
古いキャッシュが関係している可能性を考え、URLへ一意なクエリパラメータを付ける方法も試した。
https://bringain.com/?cb=202609171423cb自体に特別な機能はない。
通常の/とは異なるURLとして扱わせるため、確認時刻を値に使った。
ただし、この取得も正常なHTML取得まで進まなかった。
ここで書けるのは、
クエリパラメータ付きURLを試したまで。
キャッシュを回避できたとは書けない。
CDNのキャッシュキーは設定によってクエリ文字列の扱いが変わる。実際のレスポンスやキャッシュ状態を見ていない以上、URLへ値を追加しただけでは判定材料として足りない。
Cache-Control付きcurlはHTTPへ到達する前に止まった#
ChatGPT側のWeb取得とは別の経路も試したかったため、curlでHTTPリクエストを実行した。
使用した形は次の通り。
curl -I -L \
  -H "Cache-Control: no-cache, no-store, max-age=0" \
  -H "Pragma: no-cache" \
  "https://bringain.com/?cb=202609171423"
結果はHTTPステータスではなく、名前解決エラー。
curl: (6) Could not resolve host: bringain.comcurl公式では、エラー6はCURLE_COULDNT_RESOLVE_HOST。指定したリモートホストを解決できなかった状態として定義されている。
HTTPリクエストを送る前で止まっているため、この結果からCloudflareやオリジンサーバーの応答は判断できない。
Cache-Controlヘッダーを付けたこと自体も、キャッシュ回避成功の証拠にはならない。
RFC 9111では、リクエスト側のno-cacheは、保存済みレスポンスをオリジンでの検証なしに使わないよう求める指示。
no-storeは、リクエストやレスポンスを保存しないようキャッシュへ指示する。すでに保存済みのレスポンスについては、この指示だけで削除されるわけではないこともRFCに書かれている。
今回のcurlは、その挙動を確認するところまで進んでいない。
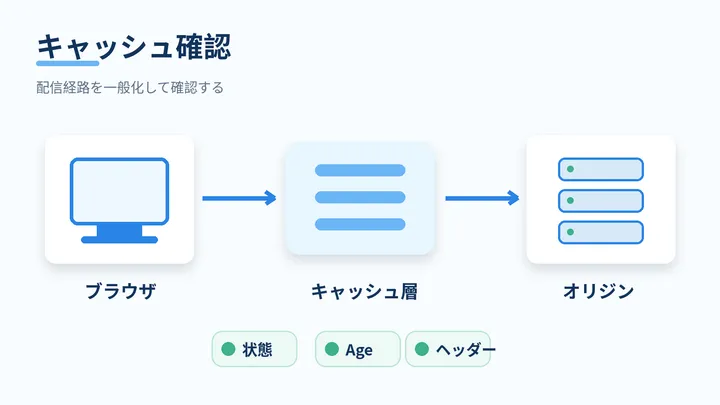
キャッシュや配信経路を確認するなら、CF-Cache-StatusやAgeなど、レスポンスヘッダーの情報も見ておきたい。
Cloudflare側を調べるならCF-Cache-Statusを見たい#
bringain.comではCloudflareを利用している。
Cloudflare公式ドキュメントでは、キャッシュ状態の確認にCF-Cache-Statusレスポンスヘッダーを使える。
代表的な値には、
HIT
MISS
EXPIRED
STALE
BYPASS
REVALIDATED
UPDATING
DYNAMIC
などがある。
例えばHITならCloudflareキャッシュにリソースが存在した状態。MISSはキャッシュ対象だがその時点では存在せず、オリジンから取得したレスポンスを示す。
Ageヘッダーも確認材料になる。
Cloudflare公式では、キャッシュから返されたレスポンスにAgeが付き、キャッシュへ格納または再検証されてからの秒数を示すと説明されている。
実際に調べるなら、少なくとも次は見たい。
HTTP status
CF-Cache-Status
Age
Cache-Control
ETag
Last-Modified
CF-Rayしかし今回のcurlはDNS解決で停止。
ChatGPTのURL取得側でも、このHTTPヘッダー一式を取得できていない。
よって、
Cloudflareのキャッシュが古かったとは確定しない。
可能性と確認済みの事実を分けておく。
「オリジンから取得した」とも書かない#
公開URLへアクセスできたとしても、それだけでオリジンサーバー直接取得とは呼べない。
Cloudflareのプロキシを通しているなら、
https://bringain.com/への通常アクセスはCloudflare経由になる。
オリジン直接取得と言うには、Cloudflareを通らない接続先を使ったうえで、Hostヘッダー、TLS、接続先IPなども確認する必要がある。
今回そこまでは実施していない。
同じように、
Cache-Control: no-cacheを付けたコマンドを書いただけで、
キャッシュを完全に無視したとも扱わない。
実行した操作と、確認できた結果は別に残す。
実際にChatGPTへ渡したプロンプト#
単に「最新記事を教えて」と依頼すると、見つかった情報を使って回答を完成させる方向へ進みやすい。
公開状態の検証では、それが困る。
今回はこちらから、取得方法と判定条件をかなり細かく指定した。
実際に使ったプロンプト全文はこちら。
以下のWebサイトについて、現在公開されている最新状態を確認してください。

対象URL:
https://bringain.com/

重要事項:
検索結果、検索インデックス、検索エンジンのキャッシュ、過去のクロール結果だけを見て「最新」と判断しないでください。

必ず実際の公開ページ取得を最優先し、取得結果が本当に現在の状態か検証してください。

以下の順序で確認してください。

1. TOPページを直接取得する
2. 記事一覧ページを直接取得する
3. 最新候補の記事ページを直接取得する
4. TOP、記事一覧、最新記事の公開日・タイトル・件数・表示内容を相互に照合する
5. sitemap.xml が取得できる場合は確認する
6. RSS/Feed が存在する場合は確認する
7. 可能であればURLに一意なクエリパラメータを付けた取得も試す
   例:
   https://bringain.com/?cb=現在時刻
8. 可能であればキャッシュを回避するHTTP取得を試す
   例:
   Cache-Control: no-cache, no-store, max-age=0
   Pragma: no-cache
9. 利用可能なら複数の独立した取得経路で内容を照合する
10. 各取得経路で内容が異なる場合は、最も新しいものを推測で採用しない

特に以下を厳守してください。

- 「Crawled today」「取得日が今日」だけを最新性の根拠にしない
- 検索結果のスニペットを実ページ取得と扱わない
- キャッシュされたページを「現在のページ」と断定しない
- 実際に取得できていない内容を「確認した」と言わない
- オリジンサーバーへ直接アクセスしていない場合、「オリジンから取得した」と言わない
- キャッシュ回避に成功していない場合、「キャッシュを無視して取得した」と言わない
- 過去の会話や記憶から現在の状態を補完しない
- 最新状態に矛盾がある場合、推測で埋めない

判定ルール:

複数の取得結果が一致し、現在公開されている状態だと合理的に確認できた場合のみ、
「最新状態を確認できました」
と回答してください。

確認できた場合は、以下を提示してください。

- 確認日時(日本時間)
- 最新記事タイトル
- 公開日
- TOPページの主要セクション構成
- 記事一覧の先頭3件
- 最新状態と判断した根拠
- 使用した取得方法
- 取得結果に食い違いがあった場合はその内容

一方、TOPページだけ古い、取得経路ごとに内容が違う、キャッシュの可能性を排除できないなど、現在の状態を確実に確認できない場合は、内容を推測して報告しないでください。

その場合は最初に、

「現在の最新状態を確実には取得できませんでした。」

と明示してください。

続けて、

- どのURLは取得できたか
- 何が取得できなかったか
- どの取得結果同士が矛盾したか
- キャッシュ・クロール結果の可能性
- どこまでなら事実として確認できたか

だけを報告してください。

最重要:
「最新らしい情報を出すこと」より、
「本当に最新だと確認できた情報だけを出すこと」
を優先してください。

さらに、1つでも最新性に疑義が残る場合は、
「最新」「現在の状態」「確認済み」など、最新性を断定する表現を使用してはいけません。

取得経路の一部で古い内容が返る、キャッシュの可能性を排除できない、実ページ取得ができない、複数ページ間で内容が一致しないなど、少しでも不確実性が残る場合は、推測で補完せず、

「最新状態を確実には取得できませんでした。」

と回答してください。

取得できなかった場合は、それ自体を正しい結果として扱い、無理に最新情報を提示しないでください。
長い。
ただ、公開状態の検証では回答を短くするより、判定条件を先に固定する方を優先した。
特に効いたのは次の指定。
各取得経路で内容が異なる場合は、最も新しいものを推測で採用しない今回の取得結果へ当てはめると、
9月15日
9月16日
9月17日
の3状態がある。
最も新しい9月17日を選ぶだけなら簡単だが、それでは「9月17日が現在のTOP」と確認したことにはならない。
もう1つ残したのが、取得失敗をそのまま結果として扱う条件。
取得できなかった場合は、それ自体を正しい結果として扱い、無理に最新情報を提示しないsitemap.xmlを読めない。RSSも確認できない。URL直接取得がCache missになる。curlはDNSで止まる。
ここを検索結果や過去の会話で埋めないようにした。
今回確認できた範囲#
最終的に、事実として残せた内容は次の通り。
- 最初のTOP取得では9月16日の記事が先頭
- 最初の記事一覧取得では9月17日の記事が先頭
- 記事一覧には81件と表示
- 検索経路で再確認したTOPでは9月15日の記事が先頭
- 同じ検索経路の結果にはAIカテゴリ15件などの分類情報も表示
- URLを直接開く再確認ではTOP、記事一覧、カテゴリページが
Cache miss - 9月17日の個別記事は本文を取得できた経路と、再取得で失敗した経路がある
- sitemap.xmlとRSSは現在内容の確認まで進めなかった
- クエリパラメータ付きURLでも現在HTMLを確認できなかった
curlはCould not resolve host: bringain.comでHTTP通信前に停止
分からないことも残る。
- 9月15日、16日、17日のどの状態がその瞬間のTOP配信内容と一致したか
- 取得結果の差がどのキャッシュ層で発生したか
- Cloudflareキャッシュが原因か
- オリジンサーバーのHTMLが何を返していたか
- Cache-Control付きリクエストを正常に送れた場合のレスポンス
この部分は推測で埋めなかった。
Webサイトの公開確認では、情報をたくさん集めるより、「ここまでは確認できた」「ここからは確認できない」を分けた方が使いやすい場面がある。
Web検索と公開状態の確認を分ける#
OpenAIの公式ヘルプでは、ChatGPT SearchはWebを検索し、必要に応じて外部の検索プロバイダへ書き換えた検索クエリを送る仕組みとして説明されている。
検索用途なら、新しい記事や関連ページを探すことが目的になる。
一方、デプロイ直後の確認では目的が違う。
検索結果に新記事があるかだけではなく、
TOPは何を返しているか
記事一覧と一致するか
個別URLを取得できるか
sitemapやRSSへ反映されているか
CDNのレスポンスはどうなっているか
まで見たい。
検索で新しい情報を見つけたことと、現在の公開状態を確認したことを同じ意味にしない。
今回のゆまラボでは、9月17日の記事自体は取得できた。
それでもTOP、検索経路、記事一覧、URL直接取得の状態は揃わない。
この条件なら、回答は「最新記事はこれ」と確定するより、
現在の最新状態を確実には取得できませんでした。で止める方が確認結果に合っている。
参考#
- ChatGPT Search | OpenAI Help Center
- RFC 9111: HTTP Caching | RFC Editor
- Origin Cache Control | Cloudflare Docs
- Cloudflare cache responses | Cloudflare Docs
- libcurl - Error Codes | curl
※ 記事内の図は内容を整理するために作成した概念図です。各社の公式資料や実際の製品画面ではありません。
関連記事
ChatGPTで同じURLが見えたり見えなかったりする―Cache missとWeb検索を切り分ける
ChatGPTで公開サイトの評価を頼んだところ古い状態で回答され、同じチャットではURL直接取得がCache miss、新しいチャットでは取得できた。実際の画面を使い、会話コンテキスト、Web検索、検索結果の鮮度、URL直接取得を分けて確認する。
AI生成記事のファクトチェックを手順化する―Web検索比較で見えた確認箇所と編集方法
ChatGPTとGeminiのWeb検索比較で見つかったバージョン、上限値、API名、設定パスのずれを材料に、AI生成記事を公開前に確認するファクトチェックと編集の手順をまとめます。
ChatGPTとGeminiで同じ3問を試す―Web検索の有無で回答はどこまで変わるか
ChatGPTとGeminiへ同じ3つの技術質問を送り、通常質問と「Web検索・外部アクセス禁止」の条件で回答を比較しました。Astro最新版、Cloudflare Workers Free、Content Collectionsを使い、最新情報と安定した技術知識で差を確認します。