ChatGPTで同じURLが見えたり見えなかったりする―Cache missとWeb検索を切り分ける
ChatGPTで公開サイトの評価を頼んだところ古い状態で回答され、同じチャットではURL直接取得がCache miss、新しいチャットでは取得できた。実際の画面を使い、会話コンテキスト、Web検索、検索結果の鮮度、URL直接取得を分けて確認する。
ゆまラボの現在の状態をChatGPTに評価してもらおうとしたところ、少し変な動きが出た。
同じサイトを見ているはずなのに、以前から使っていたチャットでは古い状態を前提に回答された。同じURLなのに会話によって見え方が変わるのは、かなり違和感がある。
そこで「今のゆまラボへアクセスして確認してほしい」と頼むと、トップURLの取得に失敗した。表示されたのは次のエラー。
Failed to fetch https://bringain.com/: Cache miss一方、ブラウザからは普通に開ける。ChatGPT側でもWeb検索は動いていて、bringain.comの記事を検索すると本文まで取得できる。
さらに新しいチャットを作り、同じトップURLを渡すと、今度は現在のトップページを取得できた。
同じ日、同じサイト、同じChatGPTで、
古いチャット
→ トップURL直接取得はCache miss
→ Web検索はできる
→ ただし検索結果は実サイトより少し古い

新しいチャット
→ トップURLを直接取得できる
→ 9月13日公開の記事まで確認できる
という差が出た。
最初は「長いチャットだから昔の情報を覚えていて、そのまま答えたのでは」と考えた。
ただ、実際に切り分けると、それだけでは説明できなかった。
会話コンテキスト、Web検索、検索結果の鮮度、特定URLの直接取得は分けて見る必要がある。
最初に起きたのは、サイト評価が以前の状態で返る現象#
きっかけは、ゆまラボのサイト評価を頼んだこと。
ゆまラボは短い期間に記事と機能をかなり追加している。連載も進み、トップページも変更している。
ところが以前から継続して使っていたChatGPTのチャットでサイト評価を頼むと、現在より前の状態を前提にした回答が返った。
ここだけなら、会話中に残っている過去の情報を使った可能性がある。
OpenAIのChatGPT FAQでも、ChatGPTは同じチャット内の文脈を使ってフォローアップへ回答すると説明されている。
長く続けているチャットには、過去に見たサイト構成、記事数、連載回数、以前のスクリーンショットなどが残っている。
そのため、最新情報を確認する必要がないと判断された場合、以前の情報が回答へ入ること自体は不自然ではない。
その後、明示的に「現在のサイトへアクセスして確認して」と頼むと別の問題が出た。
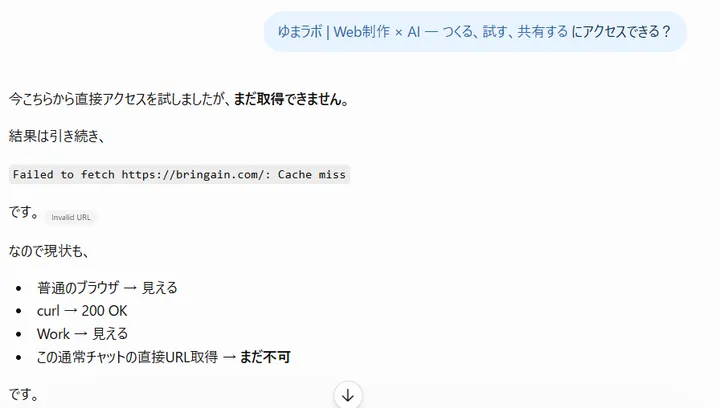
トップページの直接取得は成功せず、Cache missが返った。
この時点では、少なくとも次のどれかを考える必要がある。
- bringain.com自体へアクセスできない
- ChatGPTのWeb機能全体が使えない
- Web検索はできるが特定URLの直接取得だけ失敗している
- 一時的な取得処理の問題
- 検索結果やキャッシュには存在するが、現在URLを開く経路では取得できない
「ChatGPTから見えない」で一括りにすると、原因をかなり誤る。
Web検索は動いていた#
同じチャットでWeb検索そのものを確認した。
結果は、検索できた。
bringain.comを対象にすると記事が出る。検索結果から個別記事の本文も取得できる。最近クロールされたページにはCrawled: yesterdayという表示も出ていた。
つまり、
トップURLを直接取得
→ 失敗

Web検索
→ 成功

検索結果に出た個別記事を読む
→ 成功
という状態になっていた。
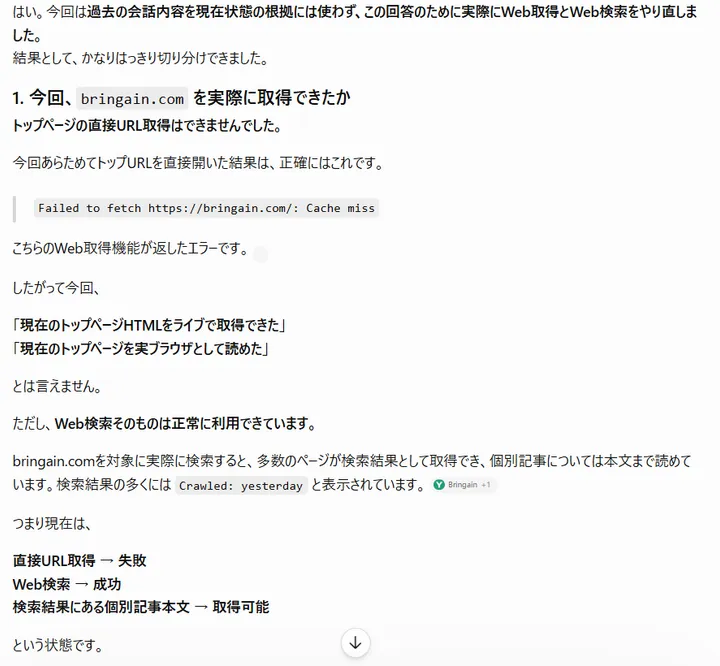
ここが今回の切り分けで重要になる。
Failed to fetch ... Cache missを見て「サイトが落ちている」「CloudflareがChatGPTを拒否している」と即断することはできない。
実際、この時点でも検索経由では同じドメインの記事を読めている。
さらに通常ブラウザではトップページを開けていた。
以前、Geminiからゆまラボを直接取得できなかったときも、Google検索とGemini側のURL取得は同じ結果にならなかった。
そのときの確認はGeminiからサイトを取得できない―GOOGLE_EXTENDED_OPT_OUTとrobots.txt・Cloudflareを確認するに残している。
今回はサービスがChatGPTに変わったが、「検索に出ること」と「指定URLをその場で取得できること」を同一視しない方がよい点は似ている。
検索結果は実サイトより少し古かった#
Web検索が動いているなら、それで現在のサイトを確認できるかというと、今回はそこにも差が出た。
「Astro+Cloudflareでサイトを作る」の最新回を検索させると、第27回までは確認できた。
一方で、第28回から第31回を個別に検索しても、その時点の検索結果には出なかった。
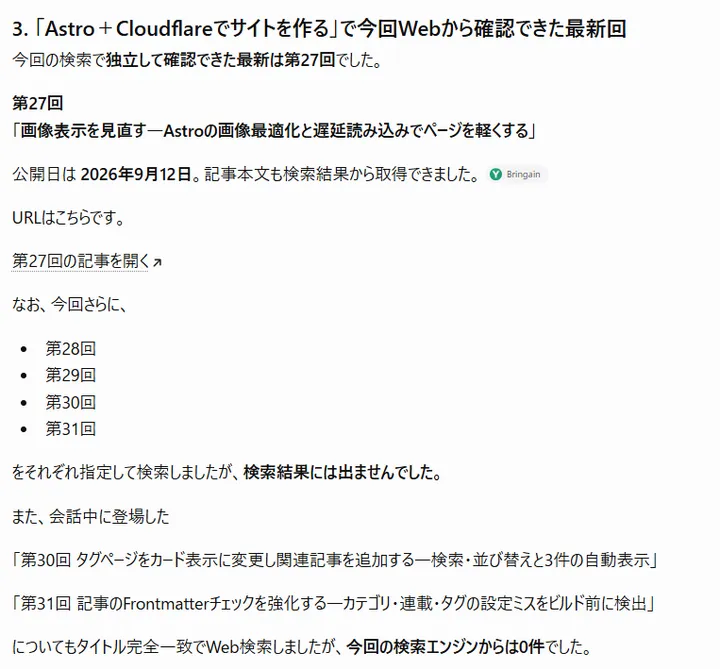
公開日の新しい記事を探したときも同じ。
検索結果から確認できた新しい記事は2026年9月12日までで、9月13日、14日を指定した検索では該当結果が返らなかった。
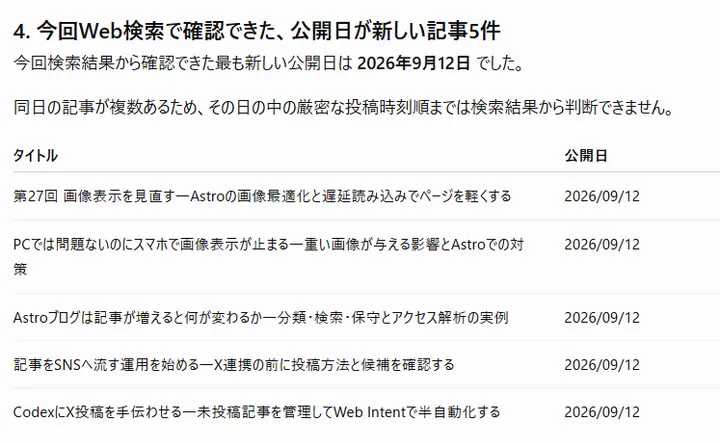
ここで面白かったのは、古いチャット自体には「第31回まで公開済み」という情報がすでにあったこと。
以前ユーザー側から提示した実画面によって、第30回、第31回まで存在することを会話コンテキストとして認識していた。
しかし、その会話履歴を根拠にせずWebだけで再確認すると、第27回までしか見つからない。
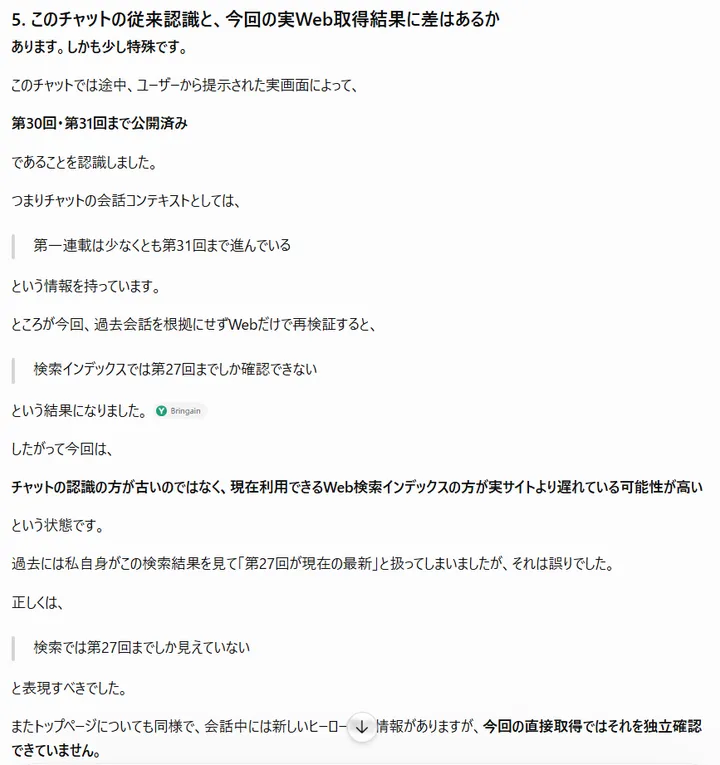
これは「チャットの記憶が古い」という説明だけでは合わない。
この時点ではむしろ、
会話コンテキスト
→ 第31回まで存在することを知っている

今回使えるWeb検索結果
→ 第27回までしか独立確認できない

トップURL直接取得
→ Cache missで失敗
という3種類の状態が同時に存在していた。
実際に使った確認用プロンプト#
曖昧なまま「最新ですか」と聞くと、過去の会話を使った回答なのか、今回Webを確認した回答なのか分かりにくい。
そこで、古いチャットへ次のプロンプトをそのまま送った。
今回このプロンプト自体も公開してよいことにした。
これから、現在のこのチャットが「ゆまラボ」のどの時点の情報を認識しているのか確認したいです。

対象サイト:
https://bringain.com/

この確認では、これまでの会話内容や以前取得した情報だけを使わず、可能であれば現在の公開サイトを実際にWeb検索またはURL取得して確認してください。

以下を順番に回答してください。

1. 現在、https://bringain.com/ を実際に取得できますか?

「アクセスできるはず」という推測ではなく、今回の回答時に実際に取得できたかを教えてください。

2. 取得できた場合、現在のトップページで確認できる以下を答えてください。

- サイトタイトル
- ヒーロー部分の主要文言
- 現在表示されている連載数

3. 「Astro+Cloudflareでサイトを作る」という連載について、現在確認できる最新回を答えてください。

以下をすべて記載してください。

- 第何回まで確認できたか
- 最新回の記事タイトル
- 公開日
- URL

過去の会話から推測せず、現在取得できた公開情報を根拠にしてください。

4. 現在のゆまラボから、公開日の新しい記事を5件確認してください。

各記事について、

- タイトル
- 公開日
- URL

を記載してください。

5. 今回実際に取得したサイトの状態と、このチャットでこれまで前提にしていた「ゆまラボ」の状態に差がありますか?

差がある場合は、

- このチャットでは以前どの時点まで認識していたか
- 今回実際に取得して確認できた状態
- どこが古かったか

を具体的に比較してください。

6. Web検索を今回実際に行ったかどうかも明記してください。

検索結果や参照元を利用した場合は、可能な範囲で出典・引用も付けてください。

---

もし https://bringain.com/ を取得できない場合は、そこで回答を終わらせず、次を確認してください。

- 「Web検索自体が利用できない」のか
- 「Web検索はできるが、このURLの直接取得だけ失敗する」のか
- bringain.com を検索した場合に検索結果は出るのか
- bringain.com 内の個別記事は検索できるのか
- 表示された正確なエラー内容または状態
- 直接URL取得とWeb検索で結果が異なるか

「アクセスできませんでした」で止めず、可能な範囲で失敗箇所を切り分けてください。

最後に、この現象について、

【確認できた事実】
【可能性として考えられる原因】

を分けて説明してください。

特に、

- 長く続いているこのチャットの過去コンテキスト
- Web検索を今回実行したかどうか
- Web検索結果やインデックスの鮮度
- URL直接取得の失敗
- 新しいチャットとの違い

が関係する可能性があるか確認してください。

推測を事実のように断定しないでください。
このプロンプトで欲しかったのは正解そのものより、「何を根拠に回答したか」を分離すること。
特に、
過去会話から知っている
検索結果で見つけた
URLを今その場で取得した
を混ぜないようにした。
AIへサイト評価を頼むときは、結果だけを見るより、この取得経路を確認した方が問題を見つけやすい。
切り分けると、Web機能全部が停止しているわけではなかった#
確認結果は次の状態になった。
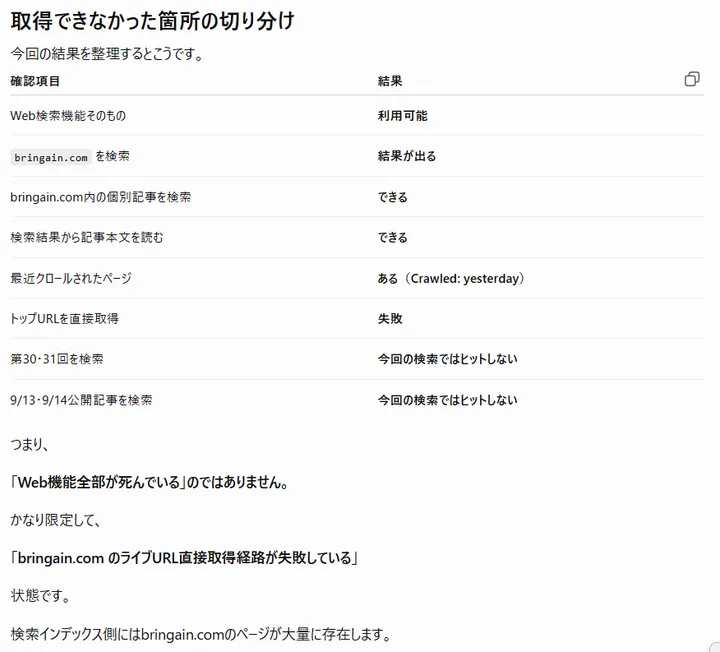
この画面から確認できる範囲では、
| 確認項目 | 結果 |
|---|---|
| Web検索機能そのもの | 利用可能 |
bringain.comを検索 | 結果が出る |
| bringain.com内の個別記事を検索 | できる |
| 検索結果から記事本文を読む | できる |
| 最近クロールされたページ | 存在する |
| トップURLを直接取得 | 失敗 |
| 第30回・第31回を検索 | その時点ではヒットしない |
| 9月13日・14日の公開記事を検索 | その時点ではヒットしない |
となった。
この結果だけで、ChatGPT内部の実装を特定することはできない。
ただし、利用者側から見た挙動として、少なくとも「検索できる」と「指定したURLを今取得できる」は同じ判定にならない場合がある。
Cache missの意味は断定しない#
今回表示された文字列は、
Failed to fetch https://bringain.com/: Cache missと表示された。
ここでCache missという言葉だけを見て、ブラウザキャッシュ、Cloudflare CDNキャッシュ、ChatGPTの会話キャッシュなど、特定のキャッシュ機構を原因と決めるのは危ない。
2026年9月14日時点で確認したOpenAIの一般向けヘルプでは、このFailed to fetch ... Cache missというエラー文字列の内部仕様までは説明されていない。
今回確認できるのは、ChatGPT側のURL取得処理が成功せず、その画面にCache missが表示されたことまで。
サイト側がHTTP 404を返した、Cloudflareが403を返した、DNSが失敗した、といった具体的なネットワーク原因は、この表示だけでは確認できない。
実際、同時期に通常ブラウザではサイトを開けている。検索結果から個別記事も読めている。そして後述する新しいチャットでは同じトップURLを取得できた。
そのため今回の記事では、Cache missを「ChatGPTのURL取得側で返ったエラー表示」として扱い、それ以上の内部原因は確定しない。
この境界はかなり大事。
技術記事でエラーメッセージを扱うとき、名前から内部実装を推測してしまうと、実際に確認した事実より説明が先へ進んでしまう。
Web検索の結果が古いことは公式にも注意されている#
OpenAIの「ChatGPTでウェブを検索する」では、ChatGPTは必要に応じて自動的にWeb検索を行い、ユーザーが手動で検索を選択することもできると説明されている。
同じページには、検索結果や引用が不完全、古い、誤っている場合があるため、引用元を開いて回答を裏付けているか、公開日や更新日も確認するよう案内がある。
今回の結果はこの注意点と一致する部分がある。
検索結果にはCrawled: yesterdayのページがあった。
それでも、サイトで公開済みと分かっている第30回、第31回や9月13日の記事が、その検索では出なかった。
「昨日クロールされたページがある」ことと「サイト全体が昨日の状態まで完全に検索可能」は同じではない。
ページごとに発見・クロール・検索結果への反映時期は違う。
また、OpenAIはパブリッシャー向けFAQで、ChatGPT検索の要約やスニペットへサイト内容を出すにはOAI-SearchBotをブロックしないよう案内している。
ただし、検索結果への掲載自体は保証されない。
ゆまラボの場合、今回の検索で多数の記事が見つかり本文も取得できているため、少なくとも「サイト全体がChatGPT検索から完全に消えている」という状態ではなかった。
AI検索用クローラーについては、以前のGoogle検索とGeminiのサイト取得は同じではない―AIクローラーを全部許可するべきか考えるでも確認した。
サービスごとに名称は違うが、検索結果に使うためのクロール、ユーザーが指定したページの取得、モデル学習は分けて考えた方が分かりやすい。
会話コンテキストは関係するが、今回の原因をそれだけにはできない#
古いチャットで古いサイト状態が出たため、最初は会話コンテキストを一番疑った。
これは候補としては残る。
OpenAIのFAQにも、ChatGPTはチャット内の文脈を使うことが書かれている。
長く続けているチャットで、以前「第27回まで」と確認した状態が残っていれば、Web検索を実行しない回答でその状態を使う可能性はある。
ただし今回、確認用プロンプトでは「過去会話を根拠にせず、今回Webを使って確認する」と明示した。
その結果、ChatGPTは実際にWeb検索を行い、検索結果から第27回まで取得した。
同じチャット内にはユーザー提示の画面から第31回まで存在する情報がある。それでもWebだけで独立確認した結果は第27回まで。
したがって、今回のずれを、
古いチャットだから昔の記憶だけで答えただけで説明するのは不十分。
少なくとも検証後の状態では、検索結果そのものの鮮度差とURL直接取得の失敗が別に存在していた。
新しいチャットでは同じトップURLを取得できた#
最後に、新しいチャットを作って同じURLを渡した。
すると、今度はトップページを取得できた。
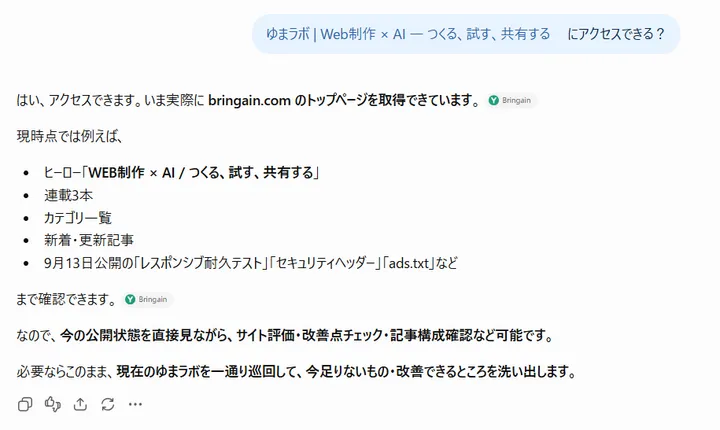
画面では、
- ヒーロー「WEB制作 × AI / つくる、試す、共有する」
- 連載3本
- カテゴリ一覧
- 新着・更新記事
- 9月13日公開の記事
まで確認できている。
古いチャット側で検索したときは9月12日までしか独立確認できなかったので、同じ時点で結果が分かれた。
ここから言えるのは、
bringain.comが継続的にアクセス不能だったわけではないということ。
新しいチャットで成功したからといって、ChatGPT内部で「チャット単位のキャッシュが壊れていた」と断定することもできない。
同じURLでも、リクエストのタイミング、利用された取得経路、内部の一時状態などが違った可能性がある。
確認できたのは「新しいチャットへ切り替えたら、その試行では取得に成功した」という実測まで。
新しいチャットを作る方法は、OpenAIのトラブルシューティングにもある#
今回は、切り分けの途中で新しいチャットへ切り替えて試した。
調べると、OpenAIのWeb検索トラブルシューティングにも「検索が表示されない、またはChatGPTにWeb検索できないと言われる場合」の確認方法として、新しい会話を開始して検索があるか確認する手順がある。
そのほか、
- ChatGPTアプリを更新する、またはブラウザ版を試す
- 意図したアカウント/ワークスペースを使っているか確認する
- 利用上限に達していないか確認する
- 管理対象ワークスペースではWeb検索が有効か管理者へ確認する
といった項目が案内されている。
今回のケースは「Web検索そのものが使えない」状態ではないので、公式手順と完全に同じ症状ではない。
それでも、別チャットで同じ操作をやり直すことは、会話固有の状態なのか、サービス全体やサイト側の問題なのかを分ける簡単なテストになる。
実際、今回はそこで結果が変わった。
現時点で考えられる原因を分ける#
今回の実測から原因を1つに確定することはできない。
候補は分けて書いた方がよい。
1. URL直接取得側の一時的な失敗#
古いチャットではトップURLを直接取得したときだけCache missになった。
その一方で、Web検索は動き、通常ブラウザでも表示でき、新しいチャットでは同じURLを取得できた。
サイト全体が停止していた場合より、ChatGPT側のURL取得処理で一時的な失敗が起きた説明の方が今回の観測には合う。
ただし、内部ログを確認できないため、それ以上は確定できない。
2. Web検索結果の反映差#
検索結果は第27回、9月12日付近まで確認できたが、それより新しいページが出なかった。
OpenAI自身も検索結果や引用が古い場合があると注意している。
今回の「サイトの現在状態を評価する」という用途では、この数日の差でも影響が大きい。
サイト構成を短期間に連続変更している場合、検索だけを見て最新状態と判断すると、すでに修正済みの問題を再度指摘する可能性がある。
3. 長いチャットの文脈#
最新確認を明示しなければ、会話内の過去情報が回答へ影響する可能性はある。
特にサイト評価のように「これまで話してきたプロジェクト」を扱うチャットでは、過去情報を使うこと自体が通常は便利。
しかし、今日の公開状態を確認したい場面では、その利点が逆に曖昧さを増やす。
指定するなら「知っている情報を答えて」より、「今この回答のためにWebを確認して」とする。
4. チャットを変えたことで取得条件が変わった可能性#
新しいチャットで成功したことは事実。
ただし、これをそのまま「新規チャットなら必ず直る」という仕様にはしない。
新しいチャットへ切り替える間に取得側の一時問題が解消した可能性もある。別の検索・取得経路が選ばれた可能性もある。
ユーザー側から内部ルーティングを確認することはできない。
新しいチャットは原因説明より、再試行と切り分けの手段として扱う。
この現象のデメリットは、エラーそのものより「古い状態で普通に回答できてしまう」こと#
今回一番困るのは、URL取得が失敗することだけではない。
明確なエラーなら気付ける。
危ないのは、検索結果や会話コンテキストに以前の情報が残っていて、回答自体は自然に成立してしまう場合。
サイト評価で、すでに直した問題を再提案される#
サイト評価を頼みたいのに、AIが数日前のページを見ていると、現在は存在しない問題を改善点として出す可能性がある。
例えば、
関連記事がない
↓
現在は追加済み

連載が第27回まで
↓
実サイトでは第31回まで進んでいる

トップページの構成が古い
↓
すでにヒーローや新着表示を変更済み
という状態。
提案内容だけを見るともっともらしいため、「AIの提案だから次の修正」と進めると二重作業になる。
公開直後の記事を「存在しない」と判断する#
今回、第30回・第31回を指定検索しても見つからなかった。
これをそのまま、
検索に出ない
→ 記事は存在しない
と判断すると誤る。
新規記事、更新直後の記事、クロールや検索結果への反映がまだ進んでいないページでは特に起きやすい。
最新記事の内部リンク候補を取りこぼす#
AIに関連記事を探させて記事へ内部リンクを入れる場合も影響する。
検索結果が古いと、公開済みの新しい関連記事を見つけられない。
逆に過去の会話だけを使うと、URL変更前の記事や古いタイトルを使う可能性がある。
内部リンクを自動で作る場合は、記事の存在確認とURL確認を別に行った方がよい。
SEOやサイト構成の判断を誤る#
「現在の記事数」「カテゴリ数」「最新公開日」「連載の進行」はサイト評価の前提になる。
そこが古いと、
- 記事数が少ない前提の提案
- カテゴリが不足している前提の提案
- 更新頻度が低いという評価
- 古いナビゲーション構成への指摘
- すでに実装した機能の再提案
につながる。
内容の正しさ以前に、観測対象が違っている。
新しいチャットへ移ると、今度は過去の作業文脈が薄くなる#
新しいチャットは今回の取得問題に対する有効な切り分けになった。
ただしデメリットもある。
古いチャットには、サイトをどう作ってきたか、何を修正したか、なぜその仕様にしたかという経緯が残っている。
新しいチャットではWebの現在状態を取得しやすくなっても、その経緯を最初からすべて知っているとは限らない。
そのため実務では、
古いチャット
→ 経緯を確認する

新しいチャット
→ 現在の公開状態を独立確認する
という使い分けもできる。
最新状態の検証では、新しいチャットの方が余計な前提を減らせる。
一方、継続作業では古いチャットの文脈が役に立つ。
どちらか一方だけを正しい使い方にする必要はない。
同じ現象が出たときの確認手順#
今回の経験から、公開サイトをChatGPTに確認させるときは次の順番が使いやすい。
URLを取得できたか明示させる#
最初に、
このURLを今回実際に取得できましたか。
過去の会話や既知の情報から推測せず回答してください。
と聞く。
「見られます」という一般論より、今回の試行で実際に取得したかを確認する。
現在状態を判別できる具体的な項目を聞く#
サイトタイトルだけでは以前と同じ場合がある。
今回なら、
最新の連載回
最新記事のタイトル
公開日
トップのヒーロー文言
記事数
など、更新で変化する項目を聞いた。
これで数日前の状態を見ているか判別しやすくなる。
直接取得に失敗したらWeb検索も試す#
URLが開けない場合、すぐに「ChatGPTからサイトへアクセス不能」と決めない。
ドメイン検索
個別記事検索
記事タイトル完全一致検索
公開日検索
を試す。
直接取得と検索が別の結果になるかを見る。
検索結果の公開日とクロール表示を見る#
検索できても、それが現在状態とは限らない。
今回のようにCrawled: yesterdayがあっても、さらに新しい記事が欠ける場合がある。
最新記事を5件程度並べさせると、検索側がどの時点まで追いついているか把握しやすい。
新しいチャットで同じURLを再試行する#
結果が不自然なら、新しいチャットで同じ質問をそのまま試す。
今回のケースでは、ここでトップURLの直接取得に成功した。
新しいチャットでも失敗するなら、チャット固有の現象という説明は弱くなる。
正確な現在画面が必要ならスクリーンショットを渡す#
Web検索の反映待ちを避けたい場合、実画面を添付する方法が確実。
サイトのデザイン評価や「この位置がおかしい」といった話では、Web取得に成功していてもスクリーンショットの方が情報量が多い。
特に公開直後の変更をその場で評価したい場合は、
公開URL
+
現在画面のスクリーンショット
の組み合わせにすると、検索インデックスの時間差に引っ張られにくい。
「Web検索した」と表示されても現在ページを見たとは限らない#
今回の経験は、以前行ったChatGPTとGeminiで同じ3問を試す―Web検索の有無で回答はどこまで変わるかともつながる。
Web検索を使っているかどうかだけでは足りない。
確認したいのは、
何を検索したか
どのページが出たか
そのページはいつの状態か
指定URLそのものを取得したか
回答のどの部分が過去会話由来か
になる。
今回、古いチャットはWeb検索を実行していた。
それでも検索結果だけでは9月13日の現在状態まで届かなかった。
「検索アイコンが付いた」「出典が出た」というだけで、ライブページの最新状態まで確認済みとは扱わない方がよい。
これはAIの回答を疑い続けるという話ではない。
最新状態が重要なタスクだけ、取得経路を確認するという使い分けになる。
例えば一般的なHTMLの説明なら、数日の差はほぼ影響しない。
一方で、
- 現在のサイト評価
- 今日公開した記事の確認
- 最新料金
- 最新バージョン
- 障害情報
- 管理画面の現行仕様
では数日の差がそのまま誤回答につながる。
実際の取得結果から言える範囲#
今回の実体験から確認できたことは、次の範囲になる。
- 古いチャットでは、
https://bringain.com/の直接取得がFailed to fetch ... Cache missで失敗した。 - 同じチャットでもWeb検索は利用できた。
- 検索結果からbringain.comの個別記事本文を取得できた。
- その検索結果では連載第27回、2026年9月12日付近まで確認できた。
- 同じチャットの会話コンテキストには、ユーザー提示の情報から第31回まで存在することが入っていた。
- 第30回、第31回や9月13日、14日の記事を指定しても、そのときのWeb検索ではヒットしなかった。
- 新しいチャットでは同じbringain.comトップURLを取得でき、9月13日公開の記事まで確認できた。
- OpenAI公式ヘルプでは、Web検索結果や引用が不完全・古い場合があると案内されている。
- OpenAI公式のWeb検索トラブルシューティングには、新しい会話を開始する手順が含まれている。
一方、今回だけでは確定できないこともある。
Cache missの内部的な発生原因- チャット単位でURL取得キャッシュが存在し、それが壊れていたか
- 新しいチャットにしたこと自体が直接の修復要因か
- URL直接取得とWeb検索が内部でどのシステムへ振り分けられたか
ここは推測で埋めない。
今回の使い方としては、
古い回答が返る
↓
今回本当にWebを確認したか聞く
↓
URL直接取得と検索を分ける
↓
最新回・公開日などで鮮度を確認する
↓
不自然なら新しいチャットで同じURLを試す
↓
必要なら実画面を添付する
まで分かれば十分実用になる。
サイトが見えないと返ってきたとき、すぐにサイト側の設定を変更する前に、ChatGPT側で「何が見えて、何が見えていないか」を分けて確認する。
今回のゆまラボでは、それだけで「Web全部が使えない」のではなく、URL直接取得と検索結果の鮮度が別の問題として見えてきた。
参考#
- OpenAI Help Center - ChatGPTでウェブを検索する
- OpenAI Help Center - ChatGPTとは: FAQ
- OpenAI Help Center - Publishers and Developers FAQ
- ゆまラボ - ChatGPTとGeminiで同じ3問を試す―Web検索の有無で回答はどこまで変わるか
- ゆまラボ - Geminiからサイトを取得できない―GOOGLE_EXTENDED_OPT_OUTとrobots.txt・Cloudflareを確認する
- ゆまラボ - Google検索とGeminiのサイト取得は同じではない―AIクローラーを全部許可するべきか考える
関連記事
ChatGPTでWebサイトの最新状態を確認する―検索結果と実ページ取得を分けて検証した記録
ChatGPTにゆまラボの公開状態を確認させたところ、TOP・記事一覧・検索経路で取得内容が一致しなかった。検索結果だけで最新と決めず、個別記事、sitemap、RSS、クエリパラメータ、Cache-Control付きHTTP取得まで分けて確認した記録。
AI生成記事のファクトチェックを手順化する―Web検索比較で見えた確認箇所と編集方法
ChatGPTとGeminiのWeb検索比較で見つかったバージョン、上限値、API名、設定パスのずれを材料に、AI生成記事を公開前に確認するファクトチェックと編集の手順をまとめます。
ChatGPTとGeminiで同じ3問を試す―Web検索の有無で回答はどこまで変わるか
ChatGPTとGeminiへ同じ3つの技術質問を送り、通常質問と「Web検索・外部アクセス禁止」の条件で回答を比較しました。Astro最新版、Cloudflare Workers Free、Content Collectionsを使い、最新情報と安定した技術知識で差を確認します。