Google検索とGeminiのサイト取得は同じではない―AIクローラーを全部許可するべきか考える
Google検索では見えているのにGeminiではページを取得できない現象をきっかけに、Googlebot、Google-Extended、AI検索用・学習用クローラー、Cloudflare側の制御を調べます。
少し前に、GeminiへゆまラボのURLを渡したところ、サイトの内容を取得できないという返答が出た。
Google検索ではページを確認できる。robots.txtも全体を拒否する設定にはしていない。それなのにGeminiでは読めない。
そのときの経緯は、Geminiがゆまラボを取得できなかったときの記事に残している。
ここで気になったのが、Google検索に出ていることと、Geminiがそのサイトを使えることは同じなのか、という点。
調べ直すと、ここは分けて考えた方がいい。
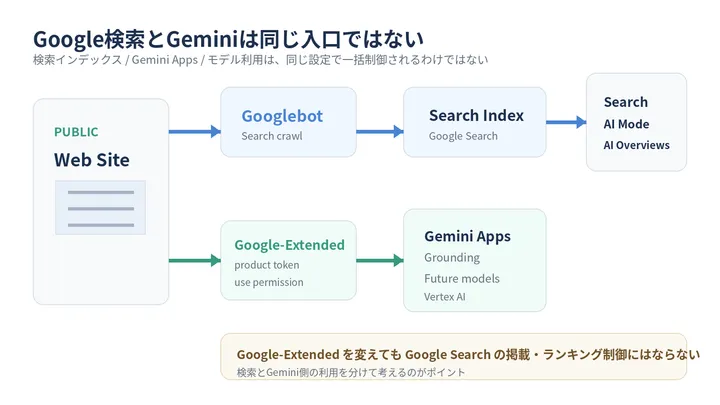
※ 記事内の図は内容を整理するために作成した概念図です。各社の公式資料や実際の製品画面ではありません。
GooglebotとGoogle-Extendedは役割が違う#
Google検索でページを見つけてインデックスへ入れる中心はGooglebot。
一方、Google-Extendedは独立した検索クローラーというより、Googleが取得したサイト内容をGemini系でどう使ってよいかを指定するためのproduct tokenとして案内されている。
Googleの説明では、Google-Extendedは将来のGeminiモデルの学習や、Gemini Apps、Vertex AI側のgroundingでサイト内容を利用するかどうかに関係する。Google検索への掲載やランキングシグナルには影響しない。
ここはかなり重要だった。
例えば次の設定があるとする。
User-agent: *
Allow: /

User-agent: Google-Extended
Disallow: /一見すると「すべて許可」に見えるが、Googleのrobots.txt処理では、より具体的に一致するuser-agentのグループが使われる。Google-Extended向けの拒否設定があれば、User-agent: *のAllowと合成されるわけではない。
つまり、
User-agent: *
Allow: /
があるからAIも全部読める、と判断するのは危ない。
逆も同じで、Google-Extendedを拒否してもGooglebotまで止まるわけではない。Google検索には普通に出るという状態があり得る。
GeminiのURL取得もGoogle検索だけでは説明できない#
Googleには通常のクローラーとは別に、ユーザー操作をきっかけにURLを取得するuser-triggered fetcherもある。
現在の公式ドキュメントには、ユーザーの要求でWebを移動するGoogle-Agent、ユーザーが指定したURLを取得するGemini Notebook用fetcherなどが載っている。Googleは、こうしたユーザー起点のfetcherは一般にrobots.txtを無視する場合があるとも説明している。
だから「GeminiがURLを読めるか」をGooglebotだけで説明するのも難しい。
Gemini Appsのgrounding、Google検索のAI機能、ユーザーが明示的にURLを渡したときの取得は、同じ名前のAI製品から見えても裏側の経路が同一とは限らない。
前の記事で起きた「Google検索では見えるのにGeminiでは取得できない」という状態も、Googlebotが通るかどうかだけを見て終わりにしない方がよさそうだ。
AIクローラーは検索・回答・学習で分かれている#
Googleだけの話でもない。
OpenAIは、ChatGPT検索向けのOAI-SearchBotとモデル学習向けのGPTBotを分けている。OpenAIのパブリッシャー向けFAQでも、ChatGPTの検索結果や要約にサイトを出したい場合はOAI-SearchBotをブロックしないよう案内している。
Anthropicも同様で、Claude-SearchBot、ユーザー要求で取得するClaude-User、モデル学習側のClaudeBotを分けている。
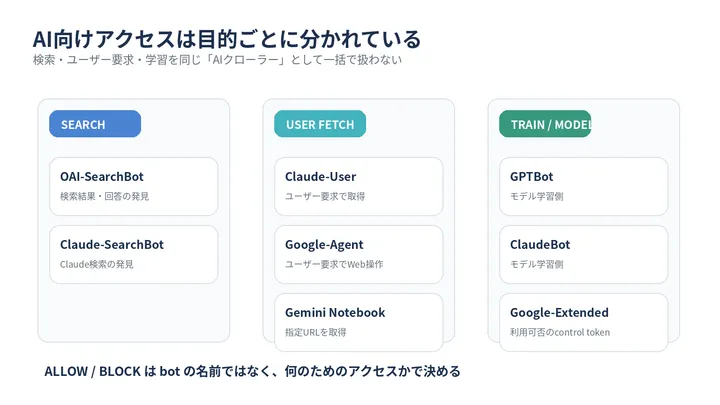
ここまで分かれていると、「AIクローラーを許可するか、ブロックするか」という二択自体が少し粗い。
検索回答に出てほしいのに検索用botを止めるのと、モデル学習だけを拒否するのは意味が違う。
学習用を許可したから将来のAI回答へ必ず出る、という保証もない。それでも、AIから見つけてもらいたいサイトが回答・検索系のアクセスまでまとめて拒否するのは、自分の目的と逆になる。
Cloudflare側の設定も確認する#
ゆまラボはCloudflare Workersで公開しているので、robots.txtだけ見れば終わりではない。
CloudflareにはAI Crawl Controlがあり、AIサービスごとのアクセス状況を見たり、個別にAllow / Blockを設定したりできる。managed robots.txtを有効にすると、既知のAIクローラー向けの指示やContent Signalsも扱える。
Content Signalsでは用途も、
search
ai-input
ai-train
のように分かれている。
searchは検索インデックス、ai-inputはリアルタイムのAI回答への入力、ai-trainは学習・ファインチューニングという整理。
この分け方はかなり分かりやすい。
robots.txtに許可を書いていても、CloudflareのWAFやAI Crawl Control側で止めていればアクセスは通らない。逆にrobots.txtはクローラーへの意思表示であって、秘密のページを守るアクセス制御にはならない。
管理画面や個人情報を含むページなら、robots.txtではなく認証やWAFで守るべきになる。
ゆまラボはAIからも読める状態を優先する#
自分は、ゆまラボのような公開技術ブログならAIクローラーを広く拒否しない方向で考えている。
今までは、
Google検索に出る
↓
検索結果から人が来る
という流れを中心に考えればよかった。
これからは、
誰かがAIへ質問する
↓
AIがWebを検索・取得する
↓
回答の根拠として自分の記事が使われる
↓
必要なら出典リンクから読みに来る
という経路も普通になっていくはず。
すでにChatGPTやClaudeはWeb検索と出典リンクを持っている。Google検索側にもAI ModeやAI Overviewsがある。
そこで公開記事へのAIアクセスをまとめて遮断すると、自分から入口を一つ減らすことになる。
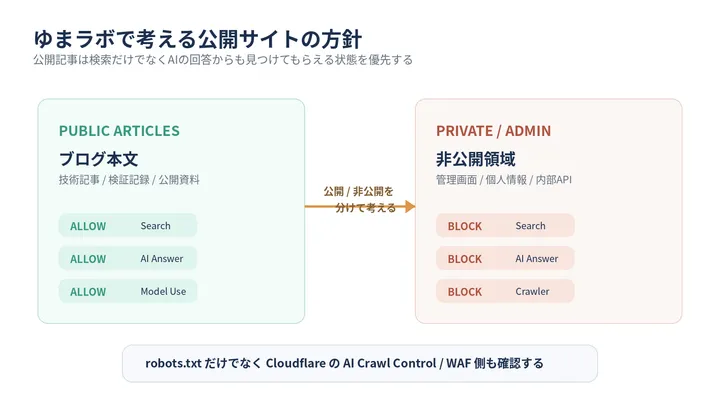
ゆまラボでは、公開してよい記事は検索エンジンにもAIにも読ませる。公開したくないものは最初から公開領域へ置かない。
今のところ、この分け方が一番分かりやすい。
AI学習への利用をどう考えるかはサイトごとに判断が分かれる。ただ、自分のサイトについては「検索には出したいが、AIには一切読ませたくない」という方針にはしない。
検索順位だけを見るSEOから、AIの回答の中で情報源として扱われることまで意識するWeb運営へ、少し対象が広がってきた感じがする。
前の記事ではGeminiが取得できないこと自体を追った。
調べ直して残ったのは、robots.txtの1行だけを見るより、誰が、何の目的で、そのページを取りに来るのかを分けて考えた方がいい、ということだった。
参考#
関連記事
Geminiからサイトを取得できない―GOOGLE_EXTENDED_OPT_OUTとrobots.txt・Cloudflareを確認する
Geminiからbringain.comを直接取得できず、URL_FETCH_STATUS_GOOGLE_EXTENDED_OPT_OUTが返った。robots.txt、Cloudflare AI Crawl Control、Google Search Consoleのライブテストを確認した記録。
ChatGPTでWebサイトの最新状態を確認する―検索結果と実ページ取得を分けて検証した記録
ChatGPTにゆまラボの公開状態を確認させたところ、TOP・記事一覧・検索経路で取得内容が一致しなかった。検索結果だけで最新と決めず、個別記事、sitemap、RSS、クエリパラメータ、Cache-Control付きHTTP取得まで分けて確認した記録。
AI生成記事のファクトチェックを手順化する―Web検索比較で見えた確認箇所と編集方法
ChatGPTとGeminiのWeb検索比較で見つかったバージョン、上限値、API名、設定パスのずれを材料に、AI生成記事を公開前に確認するファクトチェックと編集の手順をまとめます。