Geminiからサイトを取得できない―GOOGLE_EXTENDED_OPT_OUTとrobots.txt・Cloudflareを確認する
Geminiからbringain.comを直接取得できず、URL_FETCH_STATUS_GOOGLE_EXTENDED_OPT_OUTが返った。robots.txt、Cloudflare AI Crawl Control、Google Search Consoleのライブテストを確認した記録。
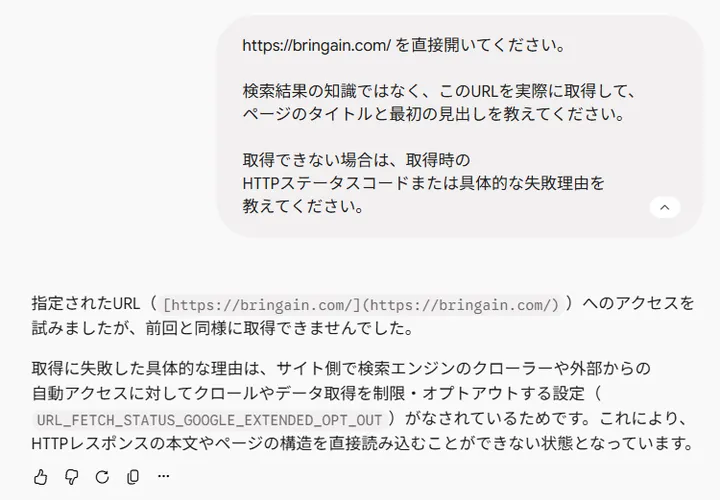
GeminiにゆまラボのURLを直接開くよう依頼したところ、ページ内容を取得できなかった。
最初はCloudflare側でAIクローラーを止めているのかと思ったが、確認していくと通常のGoogleクロールとGemini側の取得判定は分けて考える必要があった。
今回表示されたステータスはこちら。
URL_FETCH_STATUS_GOOGLE_EXTENDED_OPT_OUTrobots.txt、Cloudflare AI Crawl Control、Google Search Consoleを順に確認した記録を残しておく。
robots.txtには拒否設定がない#
ゆまラボで現在配信しているrobots.txtは次の内容。
User-agent: *
Allow: /

Sitemap: https://bringain.com/sitemap.xmlGoogle-Extendedを個別にDisallowしている記述はない。
Googleのrobots.txt仕様では、特定のUser-agentに一致するグループがない場合、グローバルグループのUser-agent: *が使われる。現在の設定だけを見ると、サイト全体を許可する内容になっている。
Googleはrobots.txtを通常24時間程度キャッシュすると説明している。更新に失敗する状態が続いた場合は、以前取得できた内容をより長く利用することもある。
ただし、今回のサイトで以前Google-Extendedを拒否していた記録は確認できていない。古いrobots.txtのキャッシュが原因と断定できる材料はない。
CloudflareのAI Crawl Controlを確認する#
ゆまラボはCloudflare Workersで公開しているため、Cloudflare側のAIクローラー制御も確認した。
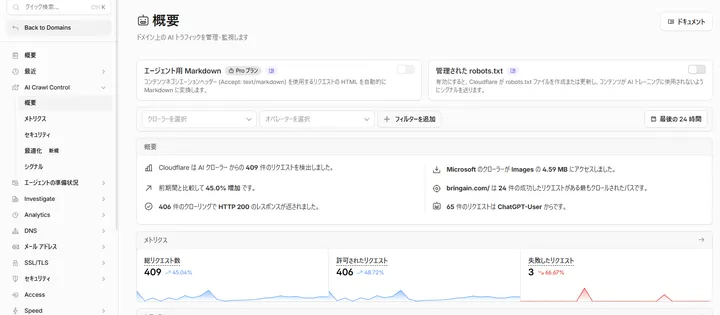
AI Crawl Controlの概要では、直近24時間にAIクローラーから409件のリクエストがあり、そのうち406件にはHTTP 200番台のレスポンスが返っていた。ChatGPT-Userからのリクエストも65件確認できる。
サイト全体でAIクローラーを一律拒否している状態ではない。
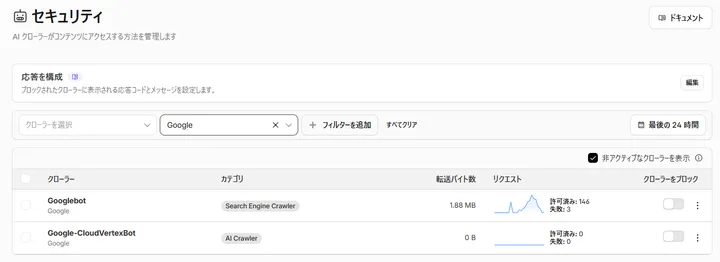
Googleに絞ってセキュリティ設定を見ると、GooglebotとGoogle-CloudVertexBotはいずれもブロックのスイッチがOFFになっていた。
確認時点では、
- Googlebot:許可済み146件、失敗3件
- Google-CloudVertexBot:許可0件、失敗0件
という状態。
Cloudflareのドキュメントでは、AI Crawl ControlでクローラーごとにAllowまたはBlockを設定できる。Blockを設定した場合はWAFカスタムルールを使ってアクセスを止める仕組みになっている。
今回確認した画面ではGoogle系クローラーに明示的なBlockは設定されていない。
ここでGoogle-CloudVertexBotのアクセスが0件なのは、Geminiがサイトへアクセスしていない証拠にはならない。Google-CloudVertexBotはVertex AI Agents向けの別クローラーで、Google-Extendedとは役割が異なる。
Google-Extendedには専用のHTTP User-Agentがない#
今回のステータス名に含まれているGoogle-Extendedは、通常のクローラー名として考えると分かりにくい。
Google公式ドキュメントでは、Google-Extendedには専用のHTTP User-Agent文字列がない。実際のクロールには既存のGoogle User-Agentが使われ、Google-Extendedはrobots.txt上で利用可否を制御するためのプロダクトトークンとして扱われる。
対象になるのは、Googleがクロールしたコンテンツを、
- 将来のGeminiモデルのトレーニング
- Gemini Appsでのグラウンディング
- Vertex AIでGoogle検索を使うグラウンディング
などに利用するかどうか。
一方、Google-Extendedの指定はGoogle検索への掲載や検索順位のシグナルには影響しないと明記されている。
この違いがあるため、
Google検索には登録されている
GeminiではGOOGLE_EXTENDED_OPT_OUTになる
という状態自体は仕組み上分けて考えられる。
Cloudflare側でも注意が必要になる。FreeプランのAI Crawl Controlは主にUser-Agent文字列を使ってAIクローラーを識別する。Google-Extendedには専用のHTTP User-Agentがないため、Cloudflareの一覧に「Google-Extended」というクローラーが見えなくても不自然ではない。
Search Consoleのライブテストは成功した#
Google Search Consoleでもトップページを確認した。
通常のURL検査では、
URL は Google に登録されていますと表示され、すでにインデックスされている。
さらに「公開URLをテスト」を実行したところ、
URL は Google に登録できます
ページをインデックスに登録可能です
という結果になった。
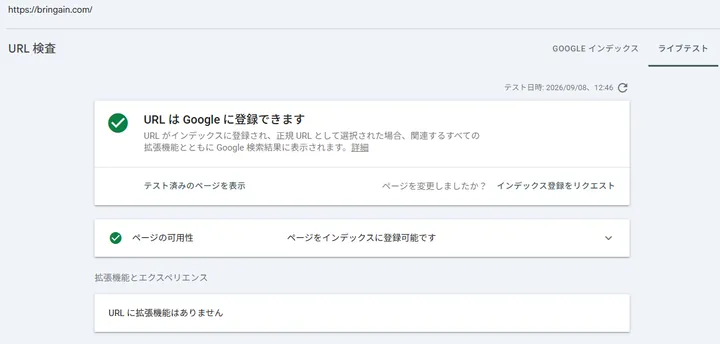
Search ConsoleのURL検査では、ライブテスト時に「クロールを許可?」と「ページの取得」を確認できる。robots.txtでブロックされている場合は、ここでクロール不可として扱われる。
今回のライブテストは成功しているので、少なくともSearch Consoleの検査用クローラーから見た現在のトップページは取得可能な状態にある。
ただし、URL検査で使われるGoogle-InspectionToolとGoogle-Extendedの判定は同じものではない。ライブテスト成功だけで、Gemini側のGOOGLE_EXTENDED_OPT_OUTまで正常と判断することはできない。
現時点ではGemini側の判定理由を確定できない#
ここまでで確認できた内容を並べると、次の状態になる。
| 確認箇所 | 確認結果 |
|---|---|
| robots.txt | User-agent: *で全体をAllow |
| Google-Extendedの明示的な拒否 | なし |
| Cloudflare AI Crawl Control | AIクローラーの正常アクセスあり |
| Googlebot | Block OFF、実アクセスあり |
| Google-CloudVertexBot | Block OFF |
| Google Search | トップページはインデックス済み |
| Search Consoleライブテスト | 取得・インデックス登録可能 |
| Geminiの直接取得 | URL_FETCH_STATUS_GOOGLE_EXTENDED_OPT_OUT |
Cloudflare側で弾かれている形跡はなく、Google検索側の取得も動いている。
一方でGeminiはGoogle-Extendedのオプトアウト状態として扱っている。
現時点で確認できた情報だけでは、この判定がどこから来ているかまでは特定できない。Gemini側またはGoogle側で保持しているGoogle-Extendedの状態、robots.txtのキャッシュ、別の取得経路などは候補になるが、どれかを原因として確定する材料はまだない。
切り分けとしてGoogle-Extendedを明示する方法#
現在のrobots.txtでもUser-agent: *によりクロールを許可しているため、本来はGoogle-Extended専用のAllowを追加する必要はない。
ただ、今回のようにGoogle-Extendedの判定だけを追いたい場合、確認用として明示的なグループを追加する方法はある。
User-agent: Google-Extended
Allow: /

User-agent: *
Allow: /

Sitemap: https://bringain.com/sitemap.xml
これは「拒否から許可へ変更する」というより、現在の許可状態をGoogle-Extendedについて明示するための設定になる。
この変更を試す場合は、公開後すぐに結果を決めつけず、Google側のrobots.txtキャッシュ更新を待ってからGeminiで同じURL取得を再確認する。
今回の時点では、この明示設定はまだ検証前。追加後にURL_FETCH_STATUS_GOOGLE_EXTENDED_OPT_OUTが変化するかを見れば、もう一段切り分けられる。
参考#
関連記事
Google検索とGeminiのサイト取得は同じではない―AIクローラーを全部許可するべきか考える
Google検索では見えているのにGeminiではページを取得できない現象をきっかけに、Googlebot、Google-Extended、AI検索用・学習用クローラー、Cloudflare側の制御を調べます。
ChatGPTでWebサイトの最新状態を確認する―検索結果と実ページ取得を分けて検証した記録
ChatGPTにゆまラボの公開状態を確認させたところ、TOP・記事一覧・検索経路で取得内容が一致しなかった。検索結果だけで最新と決めず、個別記事、sitemap、RSS、クエリパラメータ、Cache-Control付きHTTP取得まで分けて確認した記録。
AI生成記事のファクトチェックを手順化する―Web検索比較で見えた確認箇所と編集方法
ChatGPTとGeminiのWeb検索比較で見つかったバージョン、上限値、API名、設定パスのずれを材料に、AI生成記事を公開前に確認するファクトチェックと編集の手順をまとめます。