ブログの記事が増えると何が必要?分類・検索・内部リンク・保守を実例で整理
記事数が増えたブログで、分類、ページネーション、検索、内部リンク、リンク切れ確認など何が必要になったかを、ゆまラボの実例とアクセス解析から増えていく機能を分けて確認します。
記事が増えてきて、 「カテゴリが増えすぎて探しにくい」 「内部リンクやタグを人力で管理しきれない」 「Astroそのものの限界なのか、サイト設計の問題なのか分からない」 と感じていないでしょうか。数十記事になると、記事を書くことより周辺の整理・保守の方が目立ち始めます。
ゆまラボでも記事が増えるにつれ、カテゴリ・タグの正規化、ページネーション、サイト内検索、パンくず、関連記事、リンク切れ確認などが後から必要になりました。確認時点では記事一覧33件に対してページネーションがあり、外部チェッカーでサイトを巡回すると360ページ・broken link 0件と、記事数より多くの周辺ページが保守対象になっていました。
この記事では、記事数の増加で必要になった機能と、GA4などのデータが見えるようになって追加した機能を分けて整理します。小規模ブログが成長したとき、次に何を整えるべきかの実例です。
記事が増えたときのボトルネックを確認する#
まず、記事数の増加とAstroの処理能力を分けて考える。
AstroのContent Collectionsは、ブログのように同じ構造を持つコンテンツを管理するための仕組みとして用意されている。
公式ドキュメントでも、Content Collectionsはコンテンツの整理、検索、型チェック、Frontmatterの検証に使え、build-time collectionは数万件規模のコンテンツにも利用できるとしている。ページ数が非常に多い場合は、すべてをビルド時に生成せず、必要になったときにルートを生成する方法も選べる。
ゆまラボで記事が数十件になった段階では、人が記事を探す方法と、運営側が増えた情報を維持する方法が課題になった。
確認時点の記事一覧では、33件の記事に対してページネーションが表示されている。
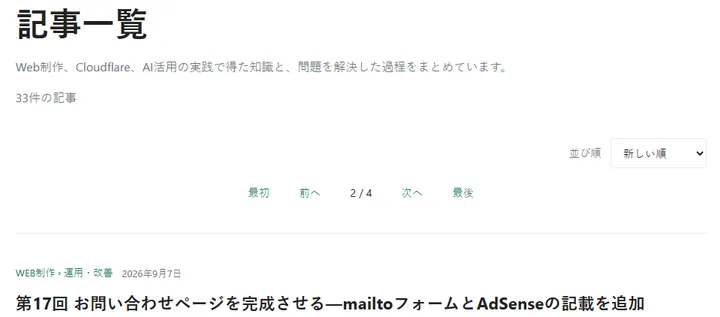
33件なら全件を1ページへ並べても技術的には表示できる。
ただ、読み手が毎回一覧を下まで探す必要はない。記事が増えた時点で、表示できるかより「目的の記事へ移動できるか」の方が気になるようになる。
一覧だけでは足りなくなり、分類と検索が必要になった#
ゆまラボでは記事数がまだ一桁の段階から、後で増えることを考えてFrontmatterへ分類情報を追加した。
AstroのFrontmatterでカテゴリ・連載を管理する方法|既存Markdownを整理では、記事の内容を分類するcategoryとsubcategory、続き物を管理するseriesとseriesOrderを分けた。
その後、Astroでカテゴリ・連載・タグ一覧を自動生成する方法|Frontmatterで記事分類で、それらを実際のナビゲーションへ使うようにした。
役割は今も分かれている。
category / subcategory
→ 記事の内容

series / seriesOrder
→ 続き物の順番

tags
→ Astro、Cloudflare、SEOなど横断的なキーワード
記事が少ないうちは、この違いを意識しなくても記事一覧から探せる。
増えてくると、例えば「Astroの記事を読みたい」と「Astro+Cloudflareの連載を最初から順番に読みたい」は別の要求になる。
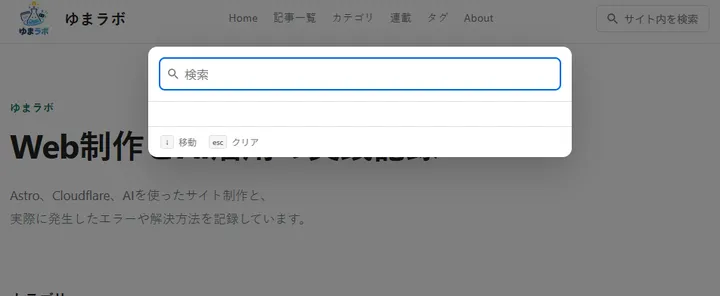
さらに記事が増れた段階では、ヘッダーへカテゴリ・連載・タグへの導線を追加し、サイト内検索も追加した。
Googleも内部リンクについて、重要なページへサイト内の別ページからリンクし、分かりやすいアンカーテキストを使うことを勧めている。一方で「内部リンクは何本必要」という決まった数はない。
記事が増えたから、すべての記事から大量の関連記事へリンクすればよいわけではない。
本文で直接関係する記事へリンクする。カテゴリ・タグ・検索から別の入口も用意する。読者が迷う箇所を見て導線を足す。
この方が運用しやすい。
記事より速く増えるのが分類ページと保守対象#
記事が30件なら、サイト全体も30ページ程度に見える。
実際はそうならない。
Astroで記事からカテゴリ、サブカテゴリ、タグ、連載、ページネーションなどを生成すると、1記事に対して複数の一覧ページが関係する。
ゆまラボでは2026年9月11日に外部のリンク切れチェッカーで確認し、以下の結果になった。
Processed 360 web pages, found 0 broken links記事数より、確認対象になったWebページ数の方がかなり多い。
無料リンク切れチェッカーでWebサイトを確認する方法|360ページを実測でも、この時点のbroken linkは0件と確認している。
記事が増えると、本文だけでなく周辺ページも保守対象になる。
例えばタグは、記事を追加するたびに新しい表記が入りやすい。
ゆまラボでは一度直したタグ重複が新規記事の追加後に再発したため、タグマスタとaliasを使う方式へ変更した。
Cloudflare Workers
cloudflare workers
のような表記違いを記事ごとに直すだけでは、次の記事で再発する可能性がある。
そこで「問題が出た記事を毎回直す」より、「追加時に同じ問題が入りにくい仕組みにする」方向へ変えた。
記事数が増えると、ページ追加に加えて整理と保守の仕組みも必要になる。
Frontmatterの検証
カテゴリ・タグの正規化
ページネーション
サイト内検索
sitemap
パンくず
内部リンク
リンク切れ確認
ビルド時の検証
のように、増えたコンテンツを壊さず維持する処理も増える。
Googleのサイトマップの説明でも、サイト内リンクが適切なら多くのページは通常のクロールで見つけられる一方、サイトが大きくなったり構造が複雑になったりすると、サイトマップが発見を補助できるとしている。
アクセス解析を始めると「必要」以外の機能も増える#
ここからは少し種類が違う。
カテゴリや検索は、記事が増えて探しにくくなったため追加した。
アクセス解析から出てくるのは、「なくても記事は読めるが、データを見ると欲しくなる機能」が多い。
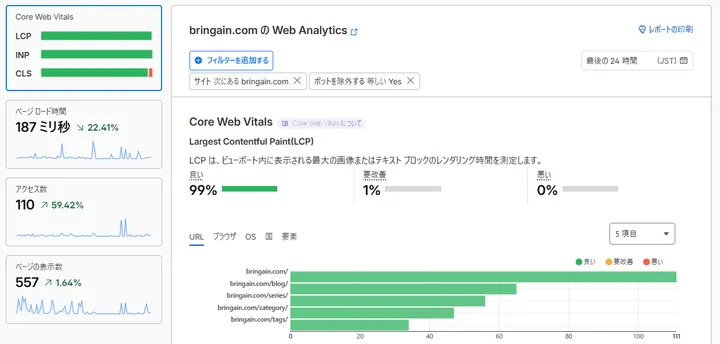
ゆまラボではCloudflare Web Analyticsでページビュー、Path、Referer、Device typeなどを確認し、その後Google Analyticsも追加した。
実際のCloudflare Web Analyticsでは、URLごとの状況やCore Web Vitalsを確認できている。
アクセス解析を見るようになると、次の疑問が出てくる。
どの記事が最近読まれているか
検索とSNSのどちらから来ているか
古い記事がまだ読まれているか
公開した新記事へ読者が移動しているか
よく読まれる記事から次に何を案内するか
ここから「注目コンテンツ」や関連記事を追加したくなる。
ゆまラボでは人気記事を自動表示するならGA4とCloudflare Analyticsどちらを使う?取得方法を比較で、トップページへ直近30日の人気記事を3~5件出す案を考えた。
条件は、
対象期間
直近30日

対象
通常の記事ページ

表示件数
3~5件

並び順
ページビューの多い順
としている。
Google Analytics Data APIの公式ドキュメントでも、直近期間の上位ページとページビューを取得する例が挙げられている。Data APIを使えば、管理画面を見て毎回手で記事を選ばなくても、レポートデータをプログラムから取得できる。
まだ「注目コンテンツを表示しないとサイトとして不足」という状態ではない。
アクセスデータを持つようになったことで、読まれている記事を次の導線へ使えるようになった、という位置づけになる。
関連記事も同じ。
記事が増えるほど「この次に読むならこれ」という候補は増える。
本文の中で直接つながる記事は手動でリンクし、一覧として見せたい関連情報はカテゴリやタグから出す、と役割を分けた方が管理しやすい。
増えたときに必要なものと、データから欲しくなるものを分ける#
今のゆまラボで起きたことを分けると、次のようになる。
| 記事が増えて必要になったもの | データが見えて欲しくなったもの |
|---|---|
| カテゴリ・サブカテゴリ | 注目コンテンツ |
| 連載管理 | 人気記事ランキング |
| タグの正規化 | 流入元別の分析 |
| ページネーション | 関連記事の出し分け |
| サイト内検索 | 読まれている記事からの次の導線 |
| パンくず・内部リンク | 更新候補の判断 |
| sitemap・リンク切れ確認 | アクセスデータを使った自動表示 |
前者は、記事数が増えるほど手作業では維持しにくくなる部分。
後者は、アクセス解析を始めたことで判断材料が増え、そのデータをサイトへ戻したくなる部分。
両方を一度に実装する必要はない。
記事が5件の段階で人気記事ランキングや複雑な関連記事ロジックを作っても、使えるデータが少ない。
逆に記事が増えているのに、カテゴリ名やタグを毎回手入力だけで管理していると、後から直す量が増える。
AstroではContent CollectionsのFrontmatterを共通データとして使えるので、
記事を書く
↓
Frontmatterを検証
↓
カテゴリ・タグ・連載へ自動反映
↓
一覧・検索・sitemapへ反映
↓
ビルド時に問題を検出
という形に寄せやすい。
アクセス解析側も、
アクセスデータを蓄積
↓
必要な指標を決める
↓
人気記事などに使う
↓
可能ならData APIで自動化
と段階を分けられる。
記事数が増えると、記事を1本追加したときに手作業で直す場所を増やさないことが重要になる。
ゆまラボでも、分類、検索、タグ、内部リンク確認、画像処理などは、記事数が増えてから同じ修正を繰り返さないための共通処理へ少しずつ置き換えてきた。
アクセス解析から出てきた「注目コンテンツ」は、その次の段階になる。
参考#
関連記事
AstroにGA4を導入する方法|Google Analytics設定からリアルタイム計測まで
Google Analyticsを初めて設定し、ゆまラボ用のGA4プロパティとWebデータストリームを作成。AstroへGoogleタグを追加してCloudflareへ反映し、リアルタイムレポートでアクセスが入るところまで確認した記録です。
GA4で自分のアクセスを除外する方法|内部トラフィックの設定と注意点
ゆまラボのGA4導入直後に自分で開いたページも計測された経験から、自分のアクセスを後から判別できるのか、内部トラフィックをIPで定義して除外する手順とデメリットを確認する。
RSSは今でも必要?ブログに残すメリットとAstroでの使い方
SNSやメール通知がある現在でもRSSを残す意味はあるのか。RSS 2.0の現状、Astroでの生成方法、Googleのサイトマップ利用、ゆまラボで残している理由を確認します。