第26回 記事内リンク切れをビルド時に検出する―記事が増えても404を残さない仕組みを作る
Astroの生成HTMLをビルド後に検査し、存在しない内部URLへのリンクがあればnpm run buildを失敗させる処理を追加。修正前後の実測、URL判定、parse5、意図的なリンク切れテストまで記録します。
第25回 ゆまラボ専用の404ページを作る―存在しないURLから記事へ戻れる導線を追加では、存在しないURLへアクセスしたときも、ゆまラボのヘッダーとフッターを表示し、トップページや記事一覧へ戻れる404ページを追加した。
404ページを作っても、記事本文やナビゲーションに残った壊れたリンクまでは直らない。
先にリンク切れがSEOに与える影響を調べた記事で、404自体をすべて消す必要はない一方、サイト自身が存在しないURLへリンクしている状態は修正対象にする方針を決めていた。
さらに、リンク切れチェッカーで公開中のゆまラボを確認した時点では、360ページを巡回してbroken linkは0件。
現在の公開サイトにリンク切れが見つからなくても、記事が増えれば新しく作る可能性はある。今回は、公開後に探すだけでなく、npm run buildの段階で内部リンク切れを検出する処理を追加する。
修正前は存在しない内部リンクがあってもビルドできる#
最初に、現在のAstroビルドがリンク切れを検出するか確認した。
通常状態で、
npm run buildを実行すると、Astroのビルド、画像処理、sitemap、Pagefindまで正常に完了した。
この時点では175ページが生成されている。
次に、既存の記事へテスト用として次のリンクを一時的に追加した。
[リンク切れ確認用](/blog/__broken-link-test__/)/blog/__broken-link-test__/という記事は存在しない。
それでも、修正前のnpm run buildは最後まで成功した。
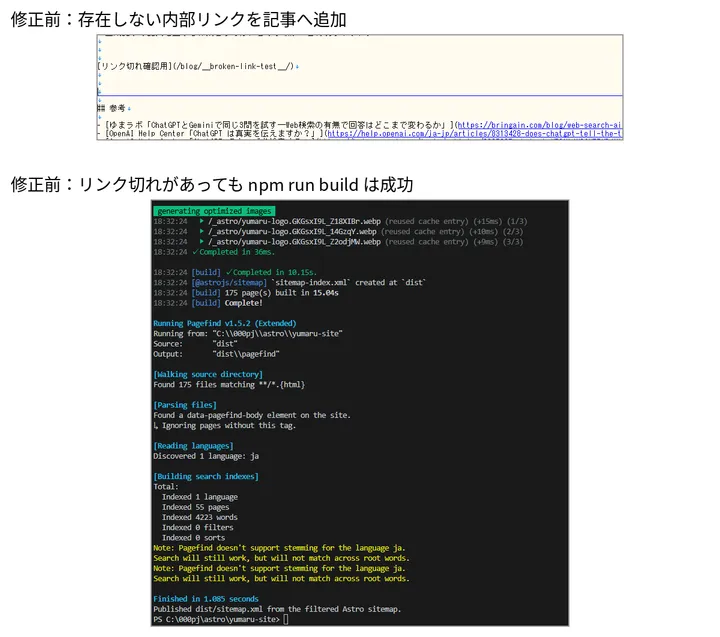
AstroはMarkdown内のリンク先ページが存在するかを確認してからHTMLを生成しているわけではない。
そのため、
記事へ内部リンクを追加
↓
リンク先が存在しない
↓
AstroはHTMLを生成
↓
npm run build成功
↓
そのまま公開できる
という状態になる。
リンク先をタイプミスした場合も同じだ。
記事数が少ないうちは目視で気付くこともある。ただ、ゆまラボでは記事本文だけでなく、カテゴリ、サブカテゴリ、連載、タグ、固定ページ、前後記事リンクなど、内部リンクを作る場所が増えている。
Markdownだけを確認するより、最終的に生成されたHTMLを確認する方が現在のサイト構成には合う。
生成されたdistのHTMLを検査する#
今回の処理は、Astroが生成したdistを対象にする。
実装後のビルドは、概ね次の順になる。
コンテンツの既存チェック
↓
Astro build
↓
Pagefind
↓
sitemapの既存処理
↓
生成HTMLの内部リンク検査
↓
0件ならbuild成功
リンク切れがあればbuild失敗リンク検査だけを別コマンドとして用意するのではなく、npm run buildの末尾から実行する。
これなら、ローカルで手動確認するときも、Cloudflare側で通常のビルドを実行するときも、同じ入口で確認できる。
今回の最終確認に使った実装では、主に次のファイルを変更した。
| ファイル | 変更内容 |
|---|---|
package.json | buildの末尾へ内部リンク検査を追加 |
package-lock.json | parse5を直接依存として登録した変更を反映 |
scripts/check-links.mjs | 生成HTMLから内部リンクを取得して存在確認 |
scripts/check-links.test.mjs | URL形式や除外条件を確認するテスト |
HTMLの解析にはparse5を使う。
parse5自体は既存依存関係の中に間接的に存在していたが、今回のスクリプトから直接利用するため、開発依存として明示した。
Codexが実際に実行した追加コマンドは次の形。
npm install --save-dev 'parse5@^7.3.0' --ignore-scripts --no-audit --no-fund文字列の正規表現だけでHTML全体を探す方法にはしなかった。
記事本文には、説明用のHTMLコードやURLがコードブロックとして入ることがある。HTMLパーサーを通し、実際の要素のhrefを対象にすることで、コード例やコメント内の文字列をリンクとして数えるのを避ける。
今回のスクリプトでは、生成HTML内のa、area、link要素からhrefを確認する。
内部URLをdist内の実ファイルへ対応させる#
単純にhref文字列とファイル名を比較するだけでは判定できない。
Astroでは、例えば、
/blog/example/というURLが、
dist/blog/example/index.htmlとして生成される。
一方で、
/rss.xml
画像
PDF
その他の静的ファイルは、HTMLページではなくファイル自体がdistへ出力される。
今回の検査では、URLをdist内の出力へ対応させて存在確認する。
末尾スラッシュの有無だけでエラーにしないことも必要になる。
また、次のようなURLも考慮した。
/blog/example/?x=1#topこの場合、今回確認したいのは/blog/example/が存在するかどうか。
query stringとhash fragmentを外してページ本体を確認する。ページ内にid="top"が本当にあるかというアンカーの検査までは、今回の範囲に含めていない。
同一サイトの絶対URLも内部リンクとして扱う。
https://bringain.com/blog/404-page-guide/これは外部リンクとして除外せず、bringain.com内のページとして確認する。
一方、別ドメインのhttp、httpsリンクへリクエストを送る処理は追加していない。
外部サイトの一時障害やアクセス制限によって、ゆまラボのビルド自体が失敗する状態にはしないためだ。
今回の検査対象からは、
外部 http://
外部 https://
mailto:
tel:
javascript:
data:
blob:
を除外している。
外部リンクの状態は、公開サイトを巡回するリンク切れチェッカーなど別の方法で確認する。
リンク切れはリンク元とリンク先を表示する#
リンク切れを検出した場合、単に「1件あります」と表示しても修正しにくい。
今回の処理では、最低限、
リンク元
リンク先
をターミナルへ表示する。
実装後、修正前と同じ形式で存在しないリンクを一時追加した。
[リンク切れ確認用](/blog/__broken-link-test__/)最終の再確認では、/blog/ai-fact-check-editing/からこのURLへリンクする状態を作っている。
npm run buildを実行すると、Astro、Pagefind、sitemapまでは処理され、その後のリンク検査で1件を検出した。
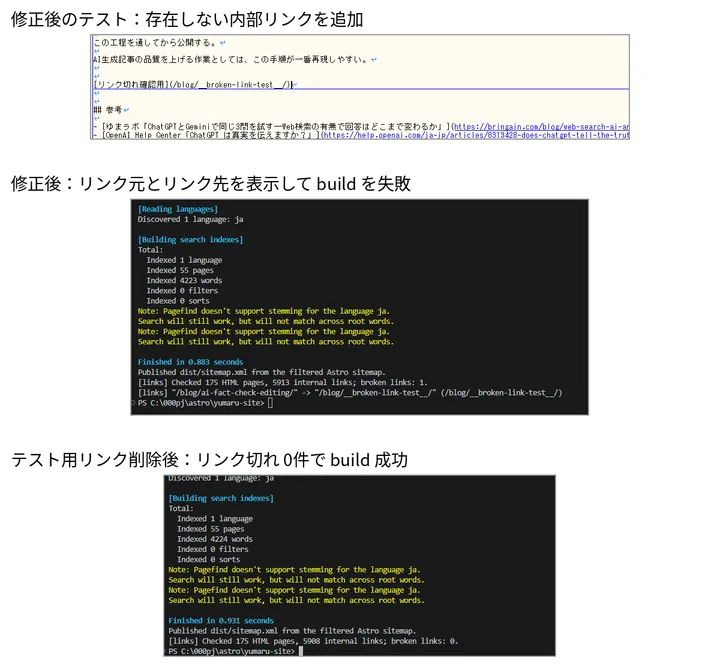
表示された内容は次の形。
[links] Checked 175 HTML pages, 5913 internal links; broken links: 1.
[links] "/blog/ai-fact-check-editing/" -> "/blog/__broken-link-test__/" (/blog/__broken-link-test__/)ここでnpm run buildは失敗する。
つまり、
存在しない内部リンクを追加
↓
通常どおりnpm run build
↓
リンク検査で検出
↓
リンク元とリンク先を表示
↓
終了コード1
までを確認できた。
最初の1件を見つけた瞬間に終了するのではなく、複数件ある場合はまとめて確認できるようにしている。
テスト用リンクを削除すると0件で通る#
リンク切れを検出できても、正常なリンクまで大量に止めるようでは使えない。
テスト用の/blog/__broken-link-test__/を記事から削除し、元の内容へ戻した。
その後、もう一度、
npm run buildを実行した。
最終確認では、
[links] Checked 175 HTML pages, 5908 internal links; broken links: 0.となり、ビルドは正常終了した。
意図的なリンク切れを入れた状態では失敗し、削除すると成功する。
正常な内部リンク、相対URL、末尾スラッシュ、query/hash付きURL、同一サイト絶対URL、日本語URL、RSS/XML、画像、PDFも確認した。
追加したテストスクリプトでは5件のケースを実行し、最終的にすべて成功している。
初回のテストでは期待するリンク件数を19件としていたが、実際の正しい件数は18件だったため、テスト側を修正して再実行した。サイト本体のリンク判定を修正したものではない。
404ページとリンク切れ検査は役割を分ける#
第25回で404ページを追加し、今回リンク切れ検査も入れた。
この2つは同じ404を扱うが、目的は別になる。
404ページ
→ 存在しないURLへ来た後の表示

内部リンク切れ検査
→ 存在しないURLへ送るリンクを公開前に見つける
存在しないURLへ直接アクセスする人を完全になくすことはできない。
外部サイトに古いURLが残っている場合もある。URLを手入力して間違える場合もある。
そのため、404ページは残す。
一方、ゆまラボ自身のHTMLから存在しないURLへリンクしている場合は、ビルド時に止める。
以前のリンク切れとSEOを確認した記事で決めた、
正しい404は残す
サイト自身が404へ送るリンクは残さない
という扱いを、ビルド処理へ入れた形になる。
既存verify.mjsの失敗は今回と分けて扱う#
実装後には既存の、
node scripts/verify.mjs
git diff --check
も実行した。
git diff --checkは成功した。
一方、verify.mjsは、
55 !== 56で停止した。
確認結果では、Markdown件数とRSS件数が一致しない既存の状態があり、重複slugの警告も出ている。
今回追加した内部リンク検査が原因ではないため、この作業ではverify.mjsや既存記事を変更していない。
リンク切れ検査の実装と、既存verifyの問題を同じ修正へ広げないようにした。
Pagefindの日本語stemming非対応案内、npmの一時ディレクトリ削除時のEPERM、Gitの改行警告なども出ているが、今回のリンク切れ検出によるビルド失敗とは区別している。
Codexのモデル比較にも同じタスクを使った#
今回の作業は、継続しているCodexでAstro改修をLunaとAstraに任せて比較する記事の検証にも使った。
LunaとAstraが互いの実装を引き継がないよう、Luna側の変更はgit stash -uで退避し、同じHEADから別ブランチを作成した。
experiment/broken-link-check-luna
experiment/broken-link-check-astra
今回、思考量は同じ条件にしていない。
Lunaは「極高」、Astraは意図的に2段下げて「中」で実行した。
そのため、これは「同じ思考量でどちらが速いか」という比較ではない。Astraの思考量を下げても、リンク切れ検出の要件を満たせるかを見る追加検証になる。
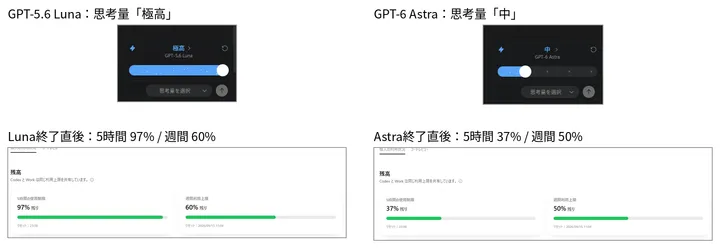
実作業時間は下記。
GPT-5.6 Luna  極高
8分6.182秒

GPT-6 Astra  中
4分20.409秒
終了直後の利用枠は、以下のようになった。
Luna終了
5時間枠 97%残り
週間枠   60%残り

Astra終了
5時間枠 37%残り
週間枠   50%残り
Astraは思考量を下げても実装自体は完了したが、利用枠表示の変化は大きい。
ただし、この数値はトークン数ではない。CodexとWorkで共有される利用枠の整数表示なので、単純に消費量の倍率として扱わない。
また、2つの実装では内部リンク件数の数え方も異なった。Luna側の最終報告では8,448件、Astra側では5,000件台になっている。
どちらも意図的なリンク切れを検出しているが、件数そのものをモデル性能の比較値にはしない。
モデルごとの実装差、所要時間、利用枠については比較記事側へ追加する。
リンク切れ検査の変更点#
修正前は、存在しない内部リンクをMarkdownへ追加してもnpm run buildが成功していた。
今回、Astroが生成したdistのHTMLを検査する処理をビルドの末尾へ追加した。
現在の確認結果は次の状態になる。
通常状態
↓
npm run build
↓
175 HTMLページを検査
↓
内部リンク切れ 0件
↓
build成功
意図的にリンクを壊すと、
/blog/__broken-link-test__/
↓
リンク切れとして検出
↓
リンク元とリンク先を表示
↓
build失敗
となる。
テストリンクを削除すると、再び0件でビルドできた。
外部サイトへHTTPリクエストは送らず、ゆまラボ内の生成結果だけを対象にしている。404ページもそのまま残している。
Codexにはcommit、push、Cloudflareへの本番デプロイを行わせていない。今回の記事で記録しているのは、ローカルのビルド処理へ内部リンク検査を追加し、正常系と意図的なリンク切れの両方を確認したところまでになる。
参考#
関連記事
第25回 ゆまラボ専用の404ページを作る―存在しないURLから記事へ戻れる導線を追加
存在しないURLでブラウザ標準の404だけが表示されていたため、Astroの404.astroを追加しました。SiteLayoutを再利用し、トップページ・記事一覧への導線、Cloudflare Workersで404を返す構成、ローカルと公開画面の確認まで記録します。
第31回 記事のFrontmatterチェックを強化する―カテゴリ・連載・タグの設定ミスをビルド前に検出
Cloudflare WorkersのビルドでseriesOrder重複を検出した経験から、FrontmatterをAstro build前に検査する処理を追加。category、subcategory、series、seriesOrder、tagsを既存schemaとtaxonomyで確認し、正常時の219ページ生成まで記録します。
第23回 カテゴリと連載に説明文を追加―連載一覧もカード表示へ変更
カテゴリ・サブカテゴリに残っていた汎用説明を実際の記事内容に合わせて変更し、連載にも共通の説明データを追加しました。/series/を説明・記事数・導線を持つカード表示へ変更した内容を記録します。