ChatGPT Images 2.5で変わった画像生成―精密編集・Sketch・高速化と残る制約
2026年9月8日に公開されたChatGPT Images 2.5について、精密編集、複数ターン編集、Sketch、Templates、最大50%の高速化を確認。ゆまラボで画像生成を使う目線から、選択範囲外の変更、生成待ち、Workでの機能差、公開前チェックなど残る制約も整理します。
OpenAIが2026年9月8日、ChatGPT Images 2.5を公開した。
Images 2.0からの更新で目立つのは、画質そのものより編集まわりの変更だ。参照画像の被写体を保ちやすくなり、指定した部分だけを変更する精度が上がった。複数回の編集でも前の変更を維持しやすくなり、生成待ち時間はImages 2.0と比べて最大50%短縮されたとしている。
ChatGPT側にはSketch、Templates、画像へのコメントといった操作も追加された。
ゆまラボでは、これまで記事用の画像やアイキャッチをAIで作っている。その中では、依頼していない企業ロゴが画像へ入ったこともあった。公開前に止めて、画像生成のルールを追加した経緯はAIに記事の画像を作ってもらったら、頼んでいない企業ロゴまで出てきたに残している。
Images 2.5で指示追従が改善しても、この確認作業まで不要になるわけではない。
今回は同じプロンプトをImages 2.0と2.5へ投げた比較テストではなく、OpenAIが公開した仕様と、ゆまラボで画像生成を使ってきたときに必要になった確認事項を合わせて見る。
Images 2.5は生成より「編集を続ける」部分が強くなった#
OpenAIの説明では、Images 2.5は自然な光や質感、参照画像の被写体保持、編集指示への追従、複数ターン編集の一貫性を改善している。
特に使い方が変わりそうなのは、一度生成した画像をそのまま完成扱いにせず、同じ画像へ修正を重ねる場面だ。
例えば記事のアイキャッチなら、最初の生成後にこういう修正が続く。
最初の画像を生成
↓
文字を減らす
↓
右側の図だけ変更
↓
背景は維持したまま配色を少し修正
↓
不要なマークを削除
以前から会話で修正指示を重ねること自体はできた。ただ、途中で関係のない部分まで変わると、修正のたびに別の場所を戻す作業が発生する。
Images 2.5では、OpenAIが「変更を依頼していない部分を保つ」方向を明確に強化している。参照画像を使う編集では、被写体や構図を維持しながら背景や一部要素を変更する用途と相性がよい。
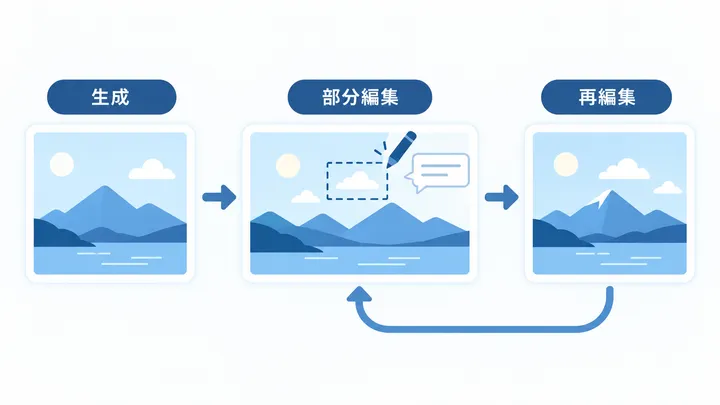
※ 記事内の図は内容を整理するために作成した概念図です。各社の公式資料や実際の製品画面ではありません。
もう一つは速度。
OpenAIはImages 2.0と比べ、画像生成の待ち時間を最大50%短縮したとしている。API側のGPT-Image-2.5 Flareについても、GPT-Image-2より50%低いレイテンシと説明している。
ただし「最大50%」なので、すべての画像が半分の時間で終わるという意味ではない。ChatGPTのヘルプにも、画像生成は内容の複雑さによって数分かかる場合があると書かれている。
速度改善は大きいが、画像生成が通常のテキスト回答と同じ感覚になるわけではない。
Sketch・Templates・コメントで指示方法が増えた#
Images 2.5では、文章だけで指示する以外の入口が増えている。
Sketchは、ChatGPT上でラフを描き、それを画像生成の参考にする機能。OpenAIのヘルプでは、現在はモバイルアプリでメッセージ欄に@を入力し、Sketchを選んで描く手順が案内されている。
文章で「右上に小さなカード、その下に矢印」と書くより、配置を線で示した方が速い場面はある。Webサイトのアイキャッチや簡単な構成図では使いやすそうだ。
Templatesは、ポスターやロゴなどの形式から開始し、必要な情報やスタイルを追加していく機能。白紙のプロンプトから作るより、用途が決まっている画像を始めやすい。
画像へのコメントも追加された。画像の特定箇所へ変更内容を付け、そこを中心に修正を依頼できる。
これらはモデル性能とは別に、入力の曖昧さを減らすためのUI側の変更と考えた方が分かりやすい。
文章だけで位置関係を伝えにくい場合、Sketchやコメントが使える。逆に、単純なアイキャッチなら従来どおりテキスト指示だけでもよい。
改善されても残る制約の方を先に見ておく#
Images 2.5は前のバージョンより扱いやすくなっている。ただ、ブログの画像生成を任せるなら、改善点より「まだ人が見る必要がある場所」を決めておいた方が運用しやすい。
部分編集でも指定範囲の外が変わる可能性がある#
OpenAIのヘルプでは、エディターで選択した範囲は必ずしも正確ではなく、選択範囲の外にも編集が及ぶ場合があると案内している。
これはImages 2.5で編集精度が改善したという説明と矛盾しない。
精度が上がったことと、編集範囲が完全に固定されることは別になる。
例えば、
見出し文字だけ削除すると依頼したとき、背景の模様、近くのアイコン、余白、線の位置まで変化しない保証はない。
公開用画像では、修正した場所だけを見るのではなく、画像全体を再確認する必要がある。
ゆまラボのアイキャッチなら、特に次を見る。
- 実在企業のロゴやロゴ風マークが増えていないか
- 日本語が崩れていないか
- 修正していない図の意味が変わっていないか
- 画像内に本文で使っていない数字が追加されていないか
- 前の指示で削除した要素が復活していないか
Images 2.5の「変更していない部分を保ちやすい」は、この確認を軽くする改善であって、確認自体をなくす機能ではない。
複数ターン編集も完全な状態固定ではない#
OpenAIは、複数回の編集で以前の変更を維持しやすくなったと説明している。
ここも表現は「より確実」「維持されやすい」であり、完全固定ではない。
アイキャッチを5回、10回と修正していくと、最初に決めた構図、線、文字、余白をどこまで維持できるかは生成内容によって変わる。
修正回数が増えすぎた場合は、途中の画像を基準にして指示を整理し直した方が扱いやすい。
変更するもの
- 右側のパネルだけ

維持するもの
- 背景
- 左側の見出し
- 配色
- 全体の構図
- 画像サイズ
Images 2.5で指示追従が上がっても、「何を変え、何を残すか」を明示する書き方はまだ使う価値がある。
高速化しても生成回数の上限が増えたわけではない#
2026年9月8日のChatGPTリリースノートでは、Images 2.5の導入に合わせて既存の画像生成上限は変更されていないと案内されている。
生成が速くなったので、短時間に試行錯誤しやすくなる。一方で、使える回数やプラン側の制限まで同時に増えたわけではない。
「速くなったから何枚でも作れる」と考えると運用がずれる。
特に複数案を大量に生成して選ぶ使い方より、最初から構図と禁止事項を絞り、少ない生成回数で修正していく方が安定する。
ゆまラボで1記事1アイキャッチにしているのも、この使い方と合う。
新機能はプラットフォームごとに同じではない#
Images 2.5自体は、デスクトップ、モバイル、WebのChatGPT、ChatGPT Work、Codexへ展開されている。
ただし、新しい操作が全部の環境で同じとは限らない。
OpenAIのヘルプではSketchをモバイルアプリの手順として案内している。また、Templatesは現時点でWorkモードでは利用できない。
モデルが利用可能かどうかと、周辺UIの機能が利用可能かどうかは分けて確認した方がよい。
記事や手順書で「Images 2.5ならSketchが使える」とだけ書くと、利用環境によって画面が一致しない可能性がある。
生成結果の文字・ロゴ・事実確認は残る#
Images 2.5ではインフォグラフィックの精度や複雑なレイアウトの扱いも改善したとされている。
それでも、OpenAIは「日本語文字が必ず正しくなる」「企業ロゴが勝手に入らない」「画像内の事実が常に正しい」とは案内していない。
ゆまラボでは以前、アクセス解析の記事用画像を作った際、依頼していないCloudflareやGoogle Analyticsのロゴが含まれた。
モデル更新後も、公開前のルールは残す。
生成
↓
文字確認
↓
ロゴ・商標確認
↓
本文と画像の内容確認
↓
サイズとトリミング確認
↓
公開
指示追従が良くなるほど、そのまま使いたくなる。ここは逆に注意が必要になる。
高いリアリティは安全上の制御も強く関係する#
OpenAIのSystem Cardでは、Images 2.5のリアリティ向上により、対策がなければ人物や出来事について、より説得力のあるディープフェイクを作れる危険が高まるとしている。
そのため、プロンプト、入力画像、編集内容、生成結果の複数段階で安全チェックを行う。
画像モデルの性能が上がっても、すべての編集要求がそのまま通るわけではない。
実在人物、センシティブな画像、誤認を招く編集などでは、安全上の制限が動くことがある。これは画像生成の失敗ではなく、サービス側の制御として存在する。
OpenAIは生成画像の識別を助けるため、C2PAメタデータと不可視の電子透かしも引き続き使用するとしている。
ChatGPTとAPIではImages 2.5の名前が少し違う#
ChatGPTで使う場合は「ChatGPT Images 2.5」として扱われる。
APIでは、同じ2.5世代として2つのモデルが用意された。
| モデル | 主な位置づけ |
|---|---|
gpt-image-2.5-flare | 速度と品質のバランスを取った標準向け。OpenAIは多くの用途でのデフォルト選択肢としている |
gpt-image-2.5-sunburst | 編集精度を優先する用途向け。より長い生成時間を使う |
FlareとSunburstは、どちらもテキストと画像を入力し、画像を出力できる。
ブログ運用を自動化してAPIから大量にアイキャッチを作るならFlare、編集精度を優先して制作物を詰めるならSunburst、という分け方が見える。
ただしChatGPT上でImages 2.5を使うだけなら、このAPIモデル名を意識する必要はない。
「ChatGPT Images 2.5」という製品側の名前と、APIで指定するモデル名を混ぜない方がよい。
ゆまラボでは生成より修正回数を減らす方に使いたい#
Images 2.5で一番使いやすくなりそうなのは、新しい画像を大量に作ることより、一度作った画像を必要な範囲だけ修正する作業だと思う。
ゆまラボの記事画像では、すでに次のルールを決めている。
- 1記事につきアイキャッチは原則1枚
- 実在企業の公式ロゴや公式アイコンを使わない
- 人物や実写風の画像を使わない
- 記事テーマに直接関係するモチーフだけを使う
- 生成後に文字、ロゴ、数値、構図を確認する
- 却下した画像を別名で再利用しない
Images 2.5の変更は、この運用を崩すものではない。
むしろ、一枚を生成してから「ここだけ直す」を繰り返しやすくなるので、複数候補を大量生成する必要は減らせる。
Sketchも同じで、文章を長くして構図を説明するより、配置だけラフで渡した方が早い記事では使える。
一方で、公開前の確認項目は残す。
新モデルになったことを理由に、生成画像を無確認で記事へ入れる運用にはしない。
参考#
関連記事
AIで作ったロゴをWebサイトへ使うまで―ゆまラボで確認した文字・サイズ・ヘッダー表示
AIで作成したゆまラボのロゴを例に、モチーフのまとめ方、画像内文字、小さいサイズでの見え方、ヘッダーへ配置するときの確認点を実際の変更前後画面と合わせてまとめます。
AIに記事の画像を作ってもらったら、頼んでいない企業ロゴまで出てきた
ゆまラボの記事用画像をAIに生成してもらったところ、指定していないCloudflareやGoogle Analyticsのロゴまで入った。公開を止め、著作権・商標・ブランドガイドラインを確認して画像生成ルールを書き直した記録。
ChatGPTでWebサイトの最新状態を確認する―検索結果と実ページ取得を分けて検証した記録
ChatGPTにゆまラボの公開状態を確認させたところ、TOP・記事一覧・検索経路で取得内容が一致しなかった。検索結果だけで最新と決めず、個別記事、sitemap、RSS、クエリパラメータ、Cache-Control付きHTTP取得まで分けて確認した記録。