GPT-6 AstraとClaude Fable 5.1を並べてみた。数字は似ているのに、任せたい仕事が少し違う
GPT-6 AstraとClaude Fable 5.1を公式情報ベースで徹底比較。料金やコンテキストは驚くほど近いのに、AstraはPC操作、Fableは長時間の深い仕事へ少し違う方向を向いています。
少し前に、GPT-6 Astraについての記事と、Claude Fable 5.1についての記事をそれぞれ書きました。
別々に調べていたときは、AstraはOpenAIの新しい最上位モデル、Fable 5.1はAnthropicの長時間作業向けモデル、くらいに見ていました。
ところが後から仕様を横に並べてみると、ちょっと変な感じがします。
コンテキストはどちらも約100万トークン。最大出力はどちらも12万8,000トークン。APIの基本料金まで、入力100万トークン10ドル、出力50ドルで同じです。しかも両方ともコーディング、調査、ドキュメント作成、長時間のエージェント作業を強く押している。
ここまで揃っていると、当然「で、結局何が違うの?」となります。
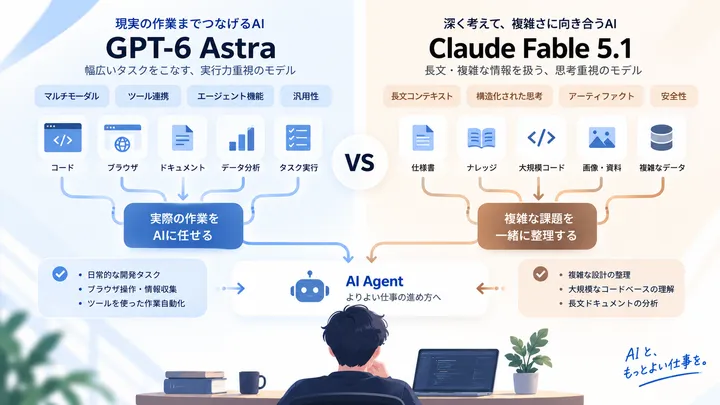
調べ直してみると、スペック表の数字よりAIにどんな仕事を持たせようとしているかに違いが見えてきました。かなり乱暴に言えば、GPT-6 Astraは「PCやツールを実際に動かして仕事を終わらせる」方向が強く、Claude Fable 5.1は「難しい仕事を長時間握らせて、深く考えながら最後まで持たせる」方向が強いです。
※ 記事内の図は比較内容を整理するために作成した概念図です。OpenAI / Anthropic の公式資料や実際の製品画面ではありません。
まず数字を並べると、本当に驚くほど近い#
最初に基本仕様だけ並べてみます。
| 項目 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 開発元 | OpenAI | Anthropic |
| リリース | 2026年9月3日 | 2026年9月1日 |
| コンテキスト | 1,050,000トークン | 1,000,000トークン |
| 最大出力 | 128,000トークン | 128,000トークン |
| API入力料金 | $10 / 100万トークン | $10 / 100万トークン |
| API出力料金 | $50 / 100万トークン | $50 / 100万トークン |
| 画像入力 | 対応 | 対応 |
| 主な用途 | 推論、コーディング、Computer Use、調査、文書作成 | 高度な推論、長時間エージェント、コーディング、調査、文書作業 |
ここだけ見たら、同じ市場を真正面から取りに来ているとしか思えません。
100万トークンクラスということは、ちょっとした質問をするための余裕ではなく、大量のソースコード、仕様書、ログ、PDF、設計資料をまとめて持たせる前提です。12万8,000トークン出力も、数段落の回答を返すための数字ではありません。
料金まで同額。
偶然似たというより、両社とも「最高性能モデルに何をさせるか」の答えが、かなり同じ場所に来ているように見えます。
チャットで一問一答するAIではなく、まとまった仕事を渡すAIです。
ただ、ここから先が面白いところでした。
Astraは「考えるAI」より「動いて終わらせるAI」に見える#
GPT-6 Astraの公式ページを読むと、Computer Useへの力の入れ方がかなり強いです。
ブラウザでフォームを埋める。CRMを更新する。カレンダーを整理する。調査した結果をメールやドキュメントへ書く。科学データを解析する。Webサイトを作って、そのままフロントエンドのQAまで行う。ソフトウェアをインストールしてテストする。
ここまで来ると、従来の「ツールを呼べるLLM」という表現では少し足りません。
Astraが狙っているのは、画面やブラウザやコードの外まで含めた一連の作業だと思います。
APIにも、その思想がかなりそのまま出ています。
async tool callingでは、外部ツールの処理を待っている間も別の仕事を進められます。mid-turn steeringでは、Astraが作業中でも追加条件を送り、それまで終えた仕事を残したまま方向を修正できます。
これ、実際の仕事の進み方にかなり近いんですよね。
ビルドを待っている間にログを見る。途中で「やっぱりこの条件も追加」と言われる。確認が必要な一点だけ人間に聞きながら、関係のない部分は先へ進める。
人間が仕事をするときには当たり前にやっていることですが、AIエージェントではこの「途中」が意外と難しかった。Astraはそこをかなり意識して作られています。
OpenAIの公表値では、OSWorld 2.0でAstraは72.6%。GPT-5.6 Solの65.7%を上回り、同社のシミュレーションでは1タスクあたりの所要時間も約75分から約40分へ短縮したとされています。
数字そのものより、OpenAIがComputer Useをここまで前面に出していることの方が気になります。
Fable 5.1は、仕事を「深く長く持ち続ける」方向が強い#
Claude Fable 5.1を見ていると、少し違う空気があります。
Anthropicが何度も使っているのは、ambitious、long-running、asynchronousといった言葉です。
コードベース全体にまたがる機能追加、コードレビュー、性能改善、数日にわたる自律セッション。自分でテストを書き、結果を確認し、失敗したら戻って直す。企業向けの複雑な調査では、途中をずっと監督するのではなく、大きな仕事を渡して完成物をレビューする。
Fable 5の時点ですでに「days-long」という方向を打ち出していましたが、5.1ではそこをさらに現実的なコストで使う方向へ持ってきています。
特に気になったのがキャッシュです。
Fable 5.1の通常料金はAstraと同じ10ドル/50ドルですが、キャッシュ読み取りは100万トークンあたり0.25ドル。Anthropicは、これによって一般的なワークロードで約25%、エージェント型では最大約45%のコスト削減になると説明しています。
長時間エージェントは、同じコードや仕様書を何度も参照します。
100万トークンを一度読めることより、巨大な前提情報を抱えたまま何度も考え直せることの方が実運用では重要かもしれません。Fable 5.1はそこにかなり寄せているように見えます。
ベンチマークを見ると「Astraが上」「Fableが上」では終わらない#
徹底比較するならベンチマークも避けられません。
ただ、ここは数字だけ切り取るとかなり危ないです。OpenAIがAstraの発表ページで掲載している比較でも、評価によって勝つモデルが変わっています。
| 評価 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| AutomationBench | 41.4% | 31.4% |
| Terminal-Bench 4.0 | 57.9% | 55.8% |
| FrontierCode 1.1 Extended | 64.5 | 63.6 |
| Internal Database Migration Tasks | 63.9% | 57.8% |
| FrontierMath Tier 4 | 97.6% | 87.8% |
| Humanity’s Last Exam(tools) | 57.2% | 65.0% |
AstraはAutomationBenchやTerminal-Bench、データベース移行などで強い数字が出ています。一方で、Humanity’s Last Examのツールあり評価ではFable 5.1が上です。
ここで「だからAstraの勝ち」「いやFableの方が賢い」と決めるのは無理があります。
ベンチマークは実行環境やツール構成、評価条件の影響をかなり受けます。しかも上の表自体がOpenAIの公表値です。OpenAIのページにも、Claude側の評価設定について脚注が付いているものがあります。
むしろ面白いのは、片方が全部圧倒しているわけではないことです。
最高性能クラスになるほど「頭の良さ」を一本の物差しで比べるのが難しくなっています。コードを書かせるのか、ブラウザを操作させるのか、巨大な文書を読ませるのか、何時間も自律実行させるのかで結果が変わる。
モデル選びがCPUのクロック比較みたいに単純だった時代は、かなり前に終わっている気がします。
似ているところの方が、実は大きな変化かもしれない#
違いを探して調べ始めたのですが、途中から逆に「なぜここまで似ているんだろう」が気になってきました。
両方とも約100万トークンを持ち、12万8,000トークンまで出力できる。コードだけでなく画像や文書を読み、ツールを使い、複数段階の仕事を進める。人間が毎ステップ確認しなくても、ある程度の判断を自分で行う。
そして両社とも「完成した仕事を人間がレビューする」という方向をかなり明確に出しています。
これまでAIを使った開発では、実装者がAIの隣に座っているような状態でした。
「このファイルを見て」
「次はここを直して」
「テストして」
「エラーが出たからログを読んで」
「じゃあ次」
AIが速くなっても、人間がずっと交通整理をしていたら、結局そこがボトルネックになります。
AstraもFable 5.1も、その人間をループの中心から少し外そうとしている。
ここはかなり大きいです。
実際の開発なら、どっちに何を任せたいか#
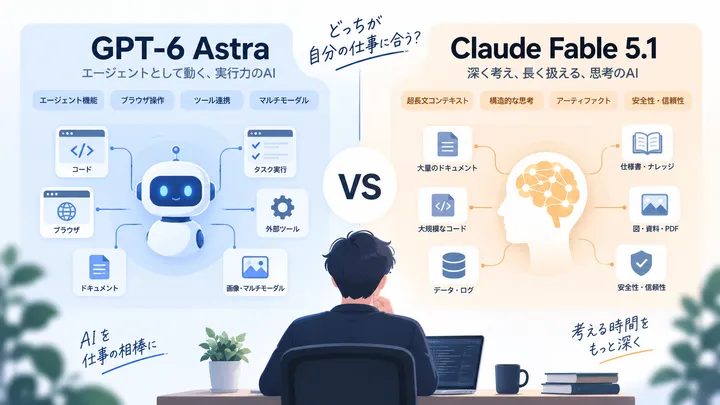
自分が業務システムの作業に当てはめるなら、現時点ではこんな分け方をします。
ブラウザ操作、管理画面、Office系の成果物、Webの調査、実際のアプリ操作まで一つにつなぎたいならAstraを先に試したいです。
例えば、既存システムの不具合調査をして、ログを読み、コードを直し、テストし、結果を表へまとめ、管理画面で状態まで確認する。途中で追加条件を出す可能性も高い。こういう「環境をまたぐ仕事」はAstraの方向性とかなり合っています。
Fable 5.1に投げたいのは、巨大なコードベースを長時間掘る仕事です。
「この機能一式を解析して、関連処理を洗い出して、設計上の問題を見つけ、修正方針を決め、実装して、自分でテストしておいて」くらいの仕事。あるいは大量の仕様書、PDF、表、設計資料を読みながら、数時間単位で調査を続ける仕事です。
もちろん、これは境界線ではありません。
Fable 5.1もブラウザを操作できますし、Astraも巨大なコードベースを扱えます。どちらも相手の得意領域へかなり入っています。
だから最終的には、モデル名で決めるより自分の仕事をそのまま両方へ渡して比べるのが一番早いと思います。
同じリファクタリングを頼む。同じ調査を頼む。同じ資料を渡す。
そこで見るべきなのはベンチマークの数点差ではなく、「途中で何回呼び戻されたか」「どれだけ修正が必要だったか」「最後の成果物をそのまま使えたか」です。
この評価軸なら仕事に直結します。
料金は同じ。でも「1仕事いくらか」はかなり変わりそう#
APIの基本単価が完全に同じなのは面白いところです。
どちらも入力10ドル、出力50ドル。
ただし実際の費用は同じにはなりません。
Astraは27万2,000トークンを超える入力では、そのリクエスト全体に長文向けの追加料金がかかります。キャッシュ入力は100万トークンあたり1ドル。Computer Useや検索など、利用するツールによって別料金が発生する場合もあります。
Fable 5.1はキャッシュ読み取りが0.25ドルで、長時間同じ前提情報を使う仕事をかなり意識した料金になっています。
でも、Astraが少ないターンでPC操作まで終わらせるなら、トータルではAstraが安くなる仕事もあるはずです。逆に、巨大なコードを何時間も保持して何度も読み返すならFableのキャッシュが効いてくるかもしれません。
ここまで来ると「1トークンいくら」だけでは比較しづらいです。
欲しいのは1タスクを終わらせるのに、結局いくら掛かったかという数字です。
AIエージェントが本格的に仕事を持つようになるほど、たぶんこの見方に変わっていきます。
今後はモデル性能より「どこまで手を離せるか」の競争になる#
GPT-6 AstraとClaude Fable 5.1を並べていて、一番強く感じたのはここです。
両社とも、もうチャット欄の回答品質だけを競っていません。
OpenAIはComputer Use、ブラウザ、ツール、途中指示、非同期実行をつなげて、AIを実際の作業環境へ出そうとしている。
Anthropicは巨大なコンテキスト、長時間のエージェント、自己検証、コーディング、ドキュメント処理を組み合わせて、人間がずっと横にいなくても仕事を保持できる方向へ進めている。
入口は少し違います。
でも最後に向かっている場所はかなり近い。
「人間がAIと会話して仕事をする」から、「人間がAIに仕事を渡す」への移行です。
ここまで来ると、今後の差別化はモデル単体のIQみたいな話だけではなくなると思います。
どのツールへ接続できるか。どのくらい安全に権限を渡せるか。途中で人間が介入しやすいか。長時間動かしても文脈を失わないか。失敗したときに自分で戻れるか。企業データをどう扱うか。キャッシュや履歴をどれだけ効率よく維持できるか。
この辺が全部「モデル性能」になっていくはずです。
そして開発者側も変わります。
AIへ一行ずつコードを書かせる能力より、どこまでを一つの仕事として切り出すか、何を勝手に判断させてよいか、どこで必ず人間へ戻すか。その設計の方が重要になる。
AstraとFable 5.1のどちらが最終的に勝つのかは、まだ分かりません。
というより、今はそこより面白いことが起きています。
OpenAIとAnthropicという別々の会社が、ほぼ同じ時期に、ほぼ同じ価格帯と巨大コンテキストを持ったモデルを出し、両方とも「長い仕事を任せてください」と言い始めた。
これはたまたまではないと思っています。
AIの使い方そのものが、次の段階に入ったということなんじゃないでしょうか。
自分が次に試したいのは、短いベンチマークではありません。
同じ既存プロジェクトをAstraとFable 5.1へ渡して、朝に仕事を投げ、数時間後に戻ってきたとき、どちらがどこまで終わらせているかを見る。
その比較なら、かなり面白そうです。
参考#
関連記事
GPT-6 Astraを調べてみた。気になったのは性能より「仕事の任せ方」の変化
OpenAIのGPT-6 Astraを公式情報から確認。105万トークンのコンテキストやComputer Useだけでなく、途中で指示を変えながら長い作業を任せる仕組みを、開発で使う目線から見てみます。
Codex CLIを実務へ入れる―チャットと違うローカル作業と便利な3つの機能
Codex CLIは、ローカルのリポジトリを直接調査し、ファイル修正やテストまで同じターミナルで進められます。AGENTS.md、レビュー、codex execを中心に、チャットとの違いと実務で使うときのポイントを確認します。
AIモデルはベンチマークだけで選ばない―LunaとAstraの実作業比較で見る開発評価
CodexのGPT-5.6 LunaとGPT-6 Astraへ同じAstro改修を任せた実測をもとに、AIモデルを開発で比べるときに見る項目を考えます。要件達成、時間、変更範囲、検証、手戻り、利用枠を分けて確認します。