AIモデルはベンチマークだけで選ばない―LunaとAstraの実作業比較で見る開発評価
CodexのGPT-5.6 LunaとGPT-6 Astraへ同じAstro改修を任せた実測をもとに、AIモデルを開発で比べるときに見る項目を考えます。要件達成、時間、変更範囲、検証、手戻り、利用枠を分けて確認します。
AIモデルの比較を見ると、最初に出てくるのはベンチマークの数字が多い。
コーディングならSWE系の評価やTerminal-Benchがあり、新しいモデルが出るたびにスコアが並ぶ。モデルの大まかな能力を見るには便利だと思う。
ただ、実際の開発で気になることは少し違う。
同じ修正を頼んだときに何分で終わるのか。必要以上にファイルを触らないか。ビルドだけでなく画面まで確認するか。途中で人間の指示が必要になるか。1日の利用枠をどれくらい使うのか。
このあたりは、ベンチマークの順位だけでは分からない。
ゆまラボでは、CodexでAstro改修をLunaとAstraへ同じ条件で任せる比較を続けている。
現在までに試したのは、TOPページの「新着・更新記事」対応と、カスタム404ページの追加。
どちらも本番サイトで必要になった小さな改修だ。
2回の結果が揃ったので、モデルの勝ち負けを決めるより、開発でAIを比較するときに何を記録すると判断しやすいかを考えてみる。
ベンチマークは候補を絞る材料になる#
GPT-6 Astraの公式発表には、複数のコーディング評価が載っている。
2026年9月10日時点では、Terminal-Bench 4.0が57.9%、DeepSWE v1.1が74.1%。OpenAIはAstraを難しいend-to-end作業向けの最上位モデルとして案内している。
一方、Codexの利用案内ではGPT-5.6 Lunaを、focusedまたはrepetitiveな作業向けの高速・低消費な選択肢としている。
この説明だけでも、使い分けの方向は分かる。
難しい作業ならAstra。
短い変更ならLuna。
ただ、実際のプロジェクトでどこから「難しい作業」になるのかは、自分のコードと依頼内容で変わる。
例えば404ページを1枚追加する仕事に、Terminal-Benchの差がそのまま出るとは限らない。
既存レイアウトを読み、1ファイルを追加し、HTTP 404を確認するだけなら、軽いモデルでも十分に終わる可能性がある。
ベンチマークはモデルを試す順番を決める材料には使える。
採用するモデルを決めるところでは、普段の作業を同じ条件で流した方が判断しやすい。
比較条件を揃えないと時間も利用枠も比べにくい#
最初のTOP改修では、同じBASE_COMMITからLuna用とAstra用のブランチを作った。
依頼した要件も同じ。
TOPの「新着記事」を「新着・更新記事」へ変更
updatedAt ?? pubDate でTOPだけ並べ替え
更新記事は更新日と公開日を分けて表示
TOP以外の並び順は変更しない
両モデルとも推論設定は「極高」で実行した。
最終的な表示は同じになった。
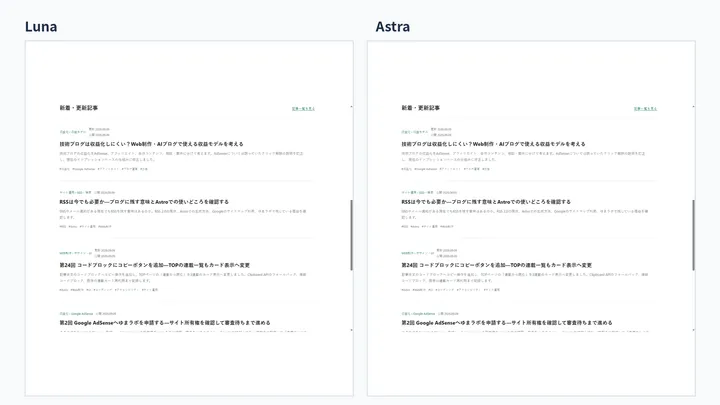
Lunaは5分17.887秒。
Astraは3分29.981秒。
Astraの方が1分47.906秒短い。
ただ、実装方法は違う。
Lunaは4ファイルを変更し、共通のソート関数や日付表示コンポーネントまで拡張した。
Astraは2ファイルに絞り、TOPで必要な処理をその近くへ置いた。
最終画面だけ見れば同じでも、コードの広げ方は違う。
この時点で、評価項目に「成功したか」と「速かったか」だけを置くと情報が足りない。
もう一つ、この初回比較には測定上の失敗もあった。
Astraが実装を終えた直後に利用枠を保存せず、その後のLuna再ビルド、HTML比較、ブラウザ確認まで続けてから画面を保存した。
Astra開始前は5時間枠98%残り、最終画面は0%。
ただし、この98ポイントをAstraの実装だけの消費として扱うことはできない。
実作業を比較するときは、どこを開始と終了にするかも先に固定する必要がある。
404ページでは終了地点まで揃えて比べた#
2回目の404ページでは、この点を修正した。
LunaとAstraを別のCodexチャットで実行し、同じBASE_COMMITから別ブランチを作った。
モデルごとに、
調査
実装
ビルド
ローカル確認
が終わったところで止め、その直後に利用枠を保存した。
結果は次の通り。
| 項目 | GPT-5.6 Luna | GPT-6 Astra |
|---|---|---|
| 実装・確認時間 | 5分16.822秒 | 3分13.527秒 |
| ソース変更ファイル | 1 | 1 |
404.astroの追加行 | 93 | 30 |
| ビルド失敗 | 0 | 0 |
| サイト実装のやり直し | 0 | 0 |
| HTTP 404確認 | preview / Wrangler | preview / Wrangler |
| ブラウザ実画面確認 | 実施できず | PC・スマホで実施 |
| 5時間枠 | 93% → 89% | 89% → 32% |
| 週間枠 | 70% → 69% | 69% → 60% |
Astraは約2分3秒短い。
Lunaを基準にすると約38.9%短縮している。
その一方で、管理画面の5時間枠はLunaが4ポイント低下、Astraが57ポイント低下した。
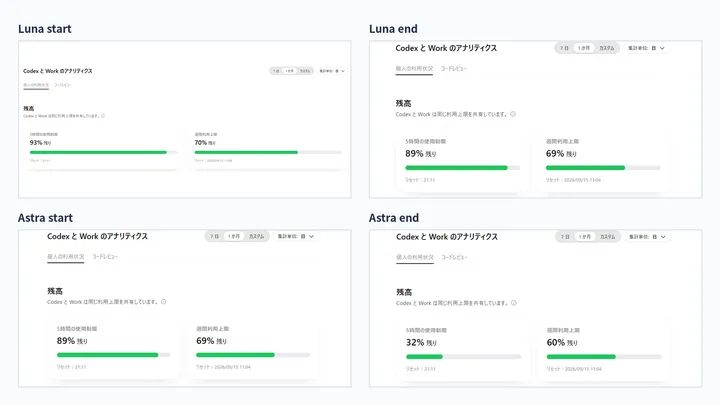
この数字をトークン消費量へ変換することはできない。
OpenAIの利用案内でも、同じタスクでもモデル、入力と出力の大きさ、推論設定、複数ステップの処理などで利用枠の消費が変わるとしている。
ただ、日中に小さな改修を何本も続ける運用では、この表示差は無視しにくい。
速さだけならAstra。
利用枠を残しながら要件を終わらせるなら、今回の404ではLunaの方が扱いやすい。
同じ「成功」でも評価は分かれる。
コードを書いた後にどこまで動くかも見る#
404比較で一番分かりやすかった差は、完成コードより検証範囲に出た。
LunaもAstro previewとWranglerを起動し、正常URLが200、存在しないURLが404になることは確認している。
ブラウザ自動操作環境は利用できないと判断し、PC・スマホ表示はHTMLとCSSの静的確認で終了した。
その途中では、previewサーバーへの初回接続、PowerShellのHttpClient型指定、Nodeコマンドのシェルクォートで検証側の失敗が3回あった。サイト本体の修正は発生していない。
Astraは別の動きをした。
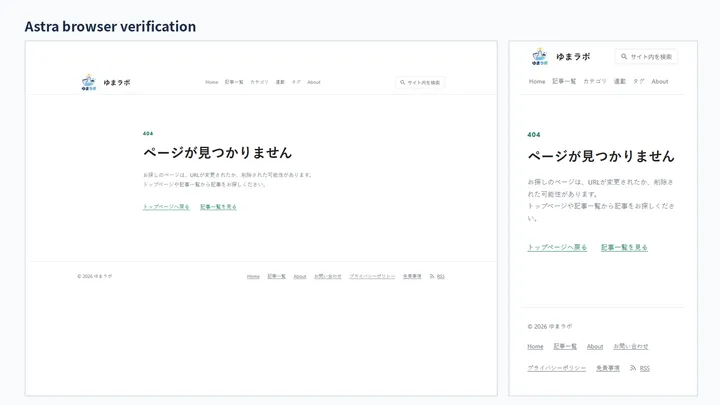
プロジェクト内にPlaywrightなどがないことを確認したあと、Windowsに入っているMicrosoft Edgeを見つけ、CDPを使ったブラウザ確認まで進めた。
Astro previewとWranglerの2環境で36回のHTTP確認を行い、正常ページ、複数の存在しないURL、HEADリクエストも確認した。
PCは1440×900。
スマホは390×844。
トップページと記事一覧へのリンクも実際にクリックしている。
Astraの利用枠が大きく減った理由を、この追加検証だけに限定することはできない。
それでも「30行の404ページを書くために57ポイント使った」と見るのも違う。
実装に加え、使えるブラウザを探し、確認方法を組み立て、PCとスマホまで見ている。
AIへ開発を任せる場合、コードの差分だけで評価すると、この部分が抜ける。
開発で記録しておきたい項目#
2回の比較を続けて、見る項目はだいたい決まってきた。
| 見る項目 | 確認する内容 |
|---|---|
| 要件達成 | 指定した機能が完成したか |
| 経過時間 | 同じ開始・終了条件で何分かかったか |
| 変更範囲 | 何ファイル、何行を変更したか |
| 実装方針 | 局所変更か、共通化まで広げたか |
| 手戻り | サイト実装、テスト、検証で何回やり直したか |
| 検証範囲 | build、HTTP、ブラウザ、PC・スマホまで見たか |
| 人間の介入 | 追加指示や途中判断が必要になったか |
| 利用枠 | 開始前後で5時間・週間枠がどう変化したか |
特に時間と利用枠は、同じチェックポイントで取らないと比較しにくい。
変更行数も、少なければ必ず良いとはしない。
LunaのTOP実装は共通部品を拡張したので変更ファイルが増えた。将来同じ表示を別ページでも使うなら再利用しやすい。
AstraはTOPだけへ処理を寄せ、今回の要求に対する影響範囲を小さくした。
ここはコード量だけでは優劣を決められない。
「なぜその範囲を変更したか」まで見る必要がある。
小さな改修はLunaから始める運用にする#
現時点の2回だけで、LunaとAstra全体の性能差を決めるつもりはない。
どちらも小規模なAstro改修で、難しい不具合調査や複数機能をまたぐ変更はまだ試していない。
ただ、今のゆまラボでモデルを選ぶ基準はかなり見えた。
要件が明確で、変更対象が1〜数ファイルに収まりそうならLunaから始める。
404ページではLunaでも5分台で実装とHTTP確認まで終わり、最終機能に不足はなかった。
難しい不具合、知らないコードの調査、複数コンポーネントを横断する改修、ブラウザを含む広い検証までまとめて任せたい場合はAstraを使う。
Astraは2回ともLunaより短時間で終わり、404では自力で確認範囲も広げた。
代わりに利用枠の消費は重い。
OpenAIの現在の案内でも、Lunaはfocused・repetitiveな作業向け、Astraは難しいcoding・research・analysis向けとしている。実測結果も、今のところこの使い分けと矛盾していない。
もう一つ、今回の比較では両モデルを「極高」で実行した。
OpenAIは、推論レベルを上げると利用枠を多く使う場合があり、高い設定が常に良い結果になるわけではないとしている。AstraについてもLowやMediumから試す案内がある。
Astraを使うなら、毎回「極高」にする必要があるのかも別に測った方がよい。
ベンチマークを見るのをやめる必要はない。
新しいモデルを試す候補を探すには使える。
ただ、開発で常用するモデルを決めるなら、普段のリポジトリから小・中・大のタスクを何本か選び、同じ開始地点と同じ終了条件で実行する。
そこで時間、差分、検証、人間の介入、利用枠を残す。
ゆまラボの2回の比較では、モデルの順位より、この記録の方が実際の使い分けに役立っている。
参考#
関連記事
CodexでAstro改修をLunaとAstraに任せて比較―小さな改修に高性能モデルは必要なのか?
CodexのGPT-5.6 LunaとGPT-6 Astraへ実際のAstro改修を任せ、TOP、404、リンク切れ検出、画像最適化で時間・差分・検証範囲・利用枠を比較。4回目はAstraを思考量「軽」まで下げましたが、5時間枠を使い切り比較タスクを完走できませんでした。
Codex CLIを実務へ入れる―チャットと違うローカル作業と便利な3つの機能
Codex CLIは、ローカルのリポジトリを直接調査し、ファイル修正やテストまで同じターミナルで進められます。AGENTS.md、レビュー、codex execを中心に、チャットとの違いと実務で使うときのポイントを確認します。
Codexで「一度だけ許可」が出続けるときの設定―Full AccessとWindows Sandboxを確認する
VS CodeのCodexでコマンド実行のたびに「一度だけ許可」が出る状態を、Permission ProfileとWindows Sandboxの設定を見直して解消した手順を記録します。